
تُمثّل معالجة السلاسل النصية وتفكيك البيانات غير المهيكلة أحد الأعمدة الجوهرية في بيئات نظم المعلومات الحاسوبية والتحليل الإحصائي الحديث. فعند استيراد البيانات من مصادر متعددة كقواعد البيانات العلاقية، ومخرجات البرمجيات المحاسبية، وسجلات خوادم الويب، يواجه محللو البيانات تحدياً بنيوياً يتمثل في دمج معلومات متفرقة داخل حقل نصي واحد؛ الأمر الذي يستلزم تقنيات متقدمة للفصل والعزل المنهجي. يُعد تطبيق مايكروسوفت إكسل (Microsoft Excel) المنصة الأكثر انتشاراً للتعامل مع هذه التحديات، حيث شهدت محركاته الحسابية تحولات نوعية تهدف إلى تعزيز دقة العمليات الحسابية وتجريد التعقيد الخوارزمي المرتبط بالصيغ التقليدية، مما يعزز موثوقية النماذج التحليلية ويقلل العبء المعرفي الواقع على عاتق المستخدمين، وهو ما يتماشى مع مفاهيم استيعاب المعلومات المعقدة في بيئات العمل الإدراكية (Pollock et al., 2002).
تتمحور إحدى أكثر العمليات تكراراً في هذا السياق حول استخراج النص الواقع قبل رمز أو محدد معين؛ كاستخلاص الاسم الأول من اسم كامل يفصل بين أجزائه فراغ، أو عزل اسم المستخدم من عنوان بريد إلكتروني قبل رمز الفصل، أو تجريد المعرفات الوظيفية وأكواد الجرد من المقاطع الرمزية الملحقة. تاريخياً، اعتمد هذا الإجراء على اقتران دالّي معقد يجمع بين دوال القص والاستعلام الموضعي، مما شكل بيئة خصبة للأخطاء التشغيلية وصعوبة الصيانة البرمجية. ومع ذلك، أحدثت التحديثات المعمارية الحديثة لمنظومة Microsoft 365 نقلة مفصلية عبر تدشين دوال نصية متخصصة ومصممة هندسياً للتعامل مع النصوص بمرونة فائقة وكفاءة حسابية متقدمة، تسهم بدورها في بناء ثقة مستدامة بين مديري البيانات والأدوات المؤتمتة (Lankton et al., 2015).
يهدف هذا الدليل الأكاديمي الشامل إلى تشريح الأبعاد الهيكلية والرياضية لعمليات استخراج النصوص قبل المحددات في مايكروسوفت إكسل. سنناقش بالتفصيل المعايير الدلالية لدالة TEXTBEFORE الحديثة، ومقارنتها بالمنهجيات التقليدية المركبة القائمة على دالتي LEFT و SEARCH، مروراً بإدارة الأخطاء وحالات الشذوذ الحسابي، وتطبيقات المصفوفات الانسكابية، وصولاً إلى استعراض حالات دراسية واقعية في قطاعات الأعمال المختلفة وحوكمة الأداء في النماذج الضخمة، لتقديم مرجع تقني استيعابي يلبي متطلبات المحللين والباحثين المتقدمين.
1. الأسس النظرية لمعالجة وتجزئة النصوص في مايكروسوفت إكسل
1.1 أهمية استخلاص السلاسل النصية في إدارة وتحليل البيانات
تلعب معالجة النصوص دوراً حاسماً في تنقية البيانات الأولية وتجهيزها للتحليل الإحصائي المتقدم والنمذجة الرياضية. في كثير من الأحيان، تحتوي قواعد البيانات المستخرجة على حقول مدمجة تضم معرفات جغرافية، أو أرقاماً وظيفية، أو سلاسل مركبة من الحروف والأرقام التي لا يمكن إخضاعها لعمليات التجميع والتصنيف المباشر دون تفكيك مسبق. تكمن التحديات المنهجية المرتبطة بالبيانات النصية غير المهيكلة في تباين أطوال النصوص، وعدم اتساق أساليب الإدخال اليدوي، ووجود مسافات خفية أو محارف تحكم غير مرئية تؤدي إلى انحراف النتائج الإحصائية.
إن التجزئة الدقيقة للنصوص تُقلل من الأخطاء الإجرائية التي قد تتسلل إلى مراحل النمذجة اللاحقة، مثل مطابقة الجداول وعمليات البحث العمودي، حيث يؤدي وجود حرف إضافي أو رمز غير معزول إلى فشل كامل في الربط العلائقي. من هنا، يبرز التحول الحتمي من المعالجة اليدوية المرهقة—القائمة على النسخ واللصق أو التعديل الفردي للخلايا—إلى الأتمتة البرمجية عبر الصيغ الجبرية المؤتمتة، مما يضمن اتساق البيانات وقابليتها للتكرار، ويوفر بيئة خالية من التناقضات المنهجية التي تؤثر سلباً على جودة القرارات الإدارية والتحليلية.
1.2 التطور المعماري لدوال النصوص: من الدوال المركبة إلى الدوال المتخصصة
على مدار عقود من تطور برنامج إكسل، واجه المستخدمون قيوداً تشغيلية واضحة ناتجة عن استخدام تركيبات الدوال الكلاسيكية المعقدة لإنجاز مهام التجزئة النصية. كان استخراج مقطع بسيط يتطلب بناء صيغ تدمج دوال استقطاع مثل LEFT مع دوال حساب الموضع مثل FIND أو SEARCH، وتضمين تعديلات جبرية مثل طرح خانة واحدة لضبط طول النص المستهدف بدقة. هذه الصيغ المركبة لم تكن تستهلك وقتاً طويلاً في الكتابة والفحص فحسب، بل كانت تمثل عبئاً حسابياً ملحوظاً وتفتقر إلى المقروئية البرمجية، مما يجعل صيانة أوراق العمل المعقدة أمراً بالغ المشقة.
تغيرت هذه المعمارية جذرياً مع إطلاق محرك الحسابات الجديد للدوال المصفوفية الديناميكية في إصدارات Microsoft 365. قامت شركة مايكروسوفت في مارس 2022 بالإعلان عن حزمة من الدوال النصية المتخصصة وطرحها لبرنامج Office Insiders، ثم إتاحتها للعامة في أواخر عام 2022. كانت الفلسفة التصميمية وراء استحداث دوال مثل TEXTBEFORE و TEXTAFTER ترتكز على تبسيط المنطق الرياضي للعمليات الشائعة، وتحويل الصيغ متعددة المستويات إلى دوال أحادية المنطق، قادرة على العمل ضمن بنية المصفوفات التلقائية وتحسين الكفاءة الحسابية واستهلاك الذاكرة في المعالجات الحديثة.
1.3 مفهوم المحددات والرموز الفاصلة في بنية النصوص الرقمية
تُعرف المحددات النصية (Delimiters) في علوم الحوسبة بأنها تتابعات من حرف واحد أو أكثر تُستخدم لتعيين الحدود الفاصلة بين مناطق مستقلة ضمن تدفق البيانات النصية. في بيئة إكسل، تعمل هذه المحددات كعلامات إرشادية تعتمد عليها الخوارزميات لتقسيم السجلات الطويلة إلى حقول دلالية ذات مغزى. تتنوع الفواصل بين محددات أحادية قياسية كالمسافة الفاصلة، والفاصلة المنقوطة، والشرطة الواصلة، وبين محددات فرعية مركبة تتألف من عدة رموز مدمجة كالأقواس المزدوجة أو النقطتين المتعاقبتين.
تعتمد خوارزميات البحث النصي على قراءة السلسلة كشريط من البايتات المتسلسلة من البداية إلى النهاية وفق ترميز محدد، لتحديد الإحداثيات الرقمية للمحدد المستهدف. يتطلب فهم سلوك هذه الخوارزميات إدراكاً لطريقة تعامل البرنامج مع النصوص متعددة اللغات، والاتجاه الفيزيائي للقراءة؛ حيث يختلف الترتيب المنطقي لتخزين الحروف في الذاكرة عن مظهرها البصري عند خلط اللغات المتباينة في الاتجاه، وهو ما يؤثر بشكل مباشر على موضع الفاصل المستهدف داخل البنية الرقمية للنص.
2. التشريح الدلالي والتركيبي لدالة TEXTBEFORE
2.1 الصيغة الرياضية العامة لدالة TEXTBEFORE والوسائط الإلزامية
تعتمد دالة TEXTBEFORE على بنية تركيبية متماسكة تتألف من وسيطتين إلزاميتين وأربع وسائط اختيارية تمنح المحلل تحكماً مطلقاً في شروط الاستخراج. تُمثَّل الصيغة العامة للدالة رياضياً وبرمجياً على النحو التالي:
TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
تمثل الوسيطة الإلزامية الأولى (text) النص المصدر أو المرجع المباشر للخلية المراد معالجتها، وتفرض القيود التقنية أن يكون هذا الإدخال نصاً صريحاً أو قيمة رقمية يمكن تحويلها برمجياً إلى تمثيل نصي؛ وفي حال تمرير مصفوفة من الخلايا، تتكفل الدالة بتطبيق العملية على كل عنصر من عناصر النطاق بشكل متزامن. أما الوسيطة الإلزامية الثانية (delimiter)، فتحدد السلسلة النصية المراد البحث عنها كعلامة توقف نهائية لعملية الاستقطاع.
يوجد فرق جوهري بين التعامل مع حرف واحد كسلسلة نصية مجردة أو كرمز؛ إذ يجب إحاطة المحدد دائماً بعلامات تنصيص مزدوجة ما لم يكن مرجعاً لخلية تحتوي على الرمز. تجدر الإشارة إلى أن دالة TEXTBEFORE لا تدعم محارف البدل التوسيعية (Wildcards) مثل النجمة أو علامة الاستفهام في وسيطة المحدد بشكل مباشر، بل تتعامل مع المحرف المدخل بقيمته الحرفية الحسابية الصرفة.
2.2 آلية المسح المتسلسل ومحددات التكرار (instance_num)
الافتراض القياسي في دالة TEXTBEFORE عند حذف الوسيطة الثالثة [instance_num] هو القيمة الافتراضية 1، وهو ما يوجه خوارزمية البحث لاقتطاع النص الواقع قبل الظهور الأول للمحدد المستهدف بدءاً من أقصى اليسار في السلسلة النصية. ومع ذلك، تتيح الدالة تجاوز هذا السلوك القياسي عبر تمرير قيم عددية صحيحة موجبة؛ فتمرير الرقم 2 يعني تجاوز التكرار الأول واستخراج كل ما يسبق التكرار الثاني للمحدد، وهكذا دواليك للتكرارات المتقدمة، مما يلغي الحاجة لتركيب دوال إضافية لحساب الإزاحة المكانية.
تتجلى المرونة المعمارية للدالة في دعمها للأرقام الصحيحة السالبة في هذه الوسيطة؛ فعند تمرير القيمة (-1)، تنعكس آلية المسح الحسابي لتبدأ من نهاية السلسلة النصية باتجاه بدايتها، مما يمكن المحلل من استهداف الفاصل الأخير في النص بكل سهولة واستخراج ما قبله كاملاً. يُعد هذا البحث العكسي حلاً رياضياً مثالياً لمعالجة البيانات ذات الأطوال غير المتجانسة والتي يتغير فيها عدد التكرارات من سجل لآخر.
2.3 التحكم في حساسية الأحرف وحالات الانتهاء
تتيح الوسائط الاختيارية المتبقية ضبط السلوك الدقيق لمحرك المطابقة النصية. تتحكم وسيطة [match_mode] في حساسية حالة الأحرف عند التعامل مع اللغات التي تفرق بين الحروف الكبيرة والصغيرة؛ فالقيمة الافتراضية 0 تجعل البحث حساساً لحالة الحرف، بينما تؤدي القيمة 1 إلى تجاهل الفروق وجعل البحث غير حساس للحالة، مما يوسع نطاق المطابقة ليتناسب مع النصوص المكتوبة بأنماط متباينة.
بدورها، تضطلع وسيطة [match_end] بدور فريد في إدارة الحالات الحدية؛ فالقيمة الافتراضية 0 تفترض أن غياب المحدد يعني فشل العملية، بينما تتيح القيمة 1 اعتبار نهاية السلسلة النصية ذاتها بمثابة محدد افتراضي، مما يؤدي إلى استخراج النص كاملاً في حال عدم العثور على الرمز الفاصل بدلاً من تعطل الصيغة. وأخيراً، توفر وسيطة [if_not_found] إمكانية تمرير قيمة تعويضية مخصصة، كإرجاع نص بديل أو إبقاء الخلية فارغة، لتلافي إطلاق رسائل الخطأ النظامية التي قد تعطل النماذج التقريرية النهائية.
3. التطبيقات العملية الأساسية: استخراج النصوص قبل الفواصل القياسية
3.1 استخراج الاسم الأول عبر عزل النص قبل المسافة الأولى
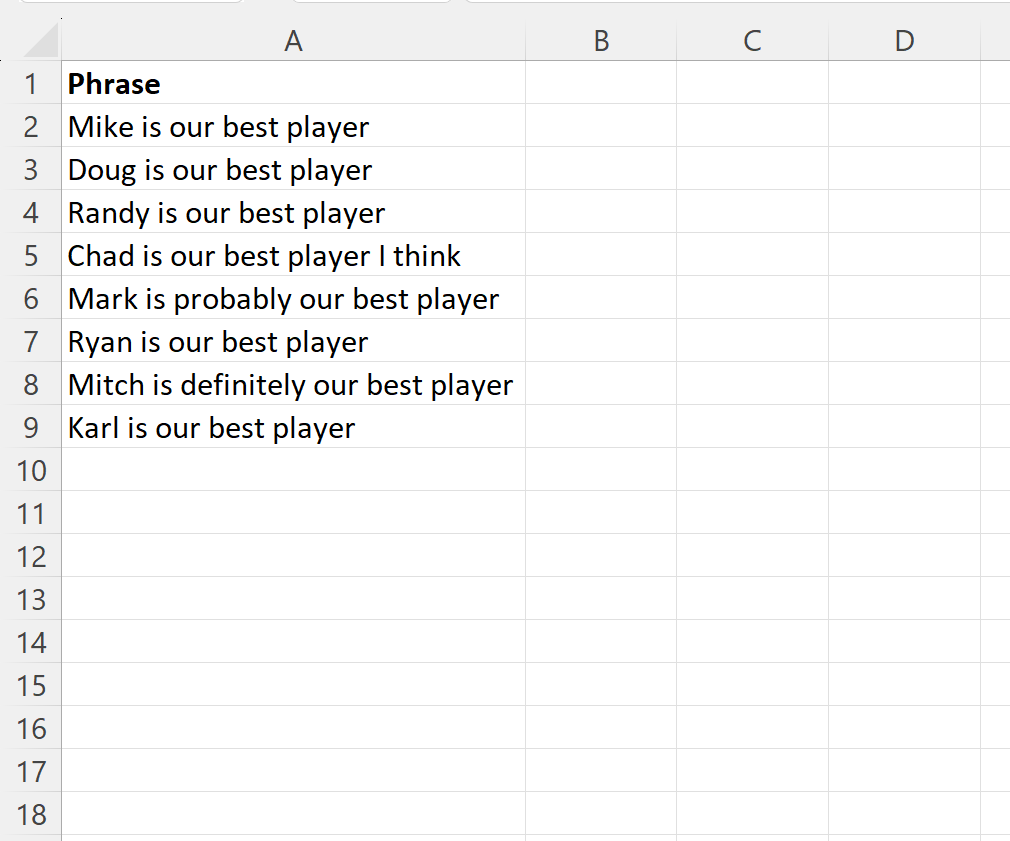
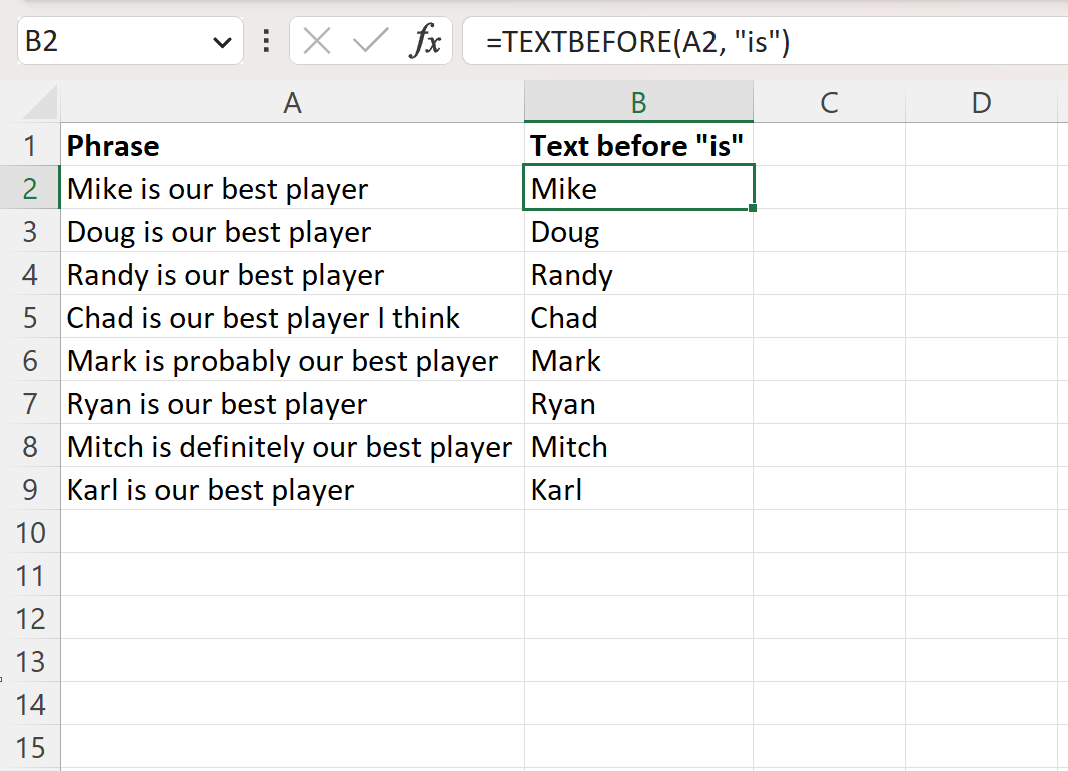
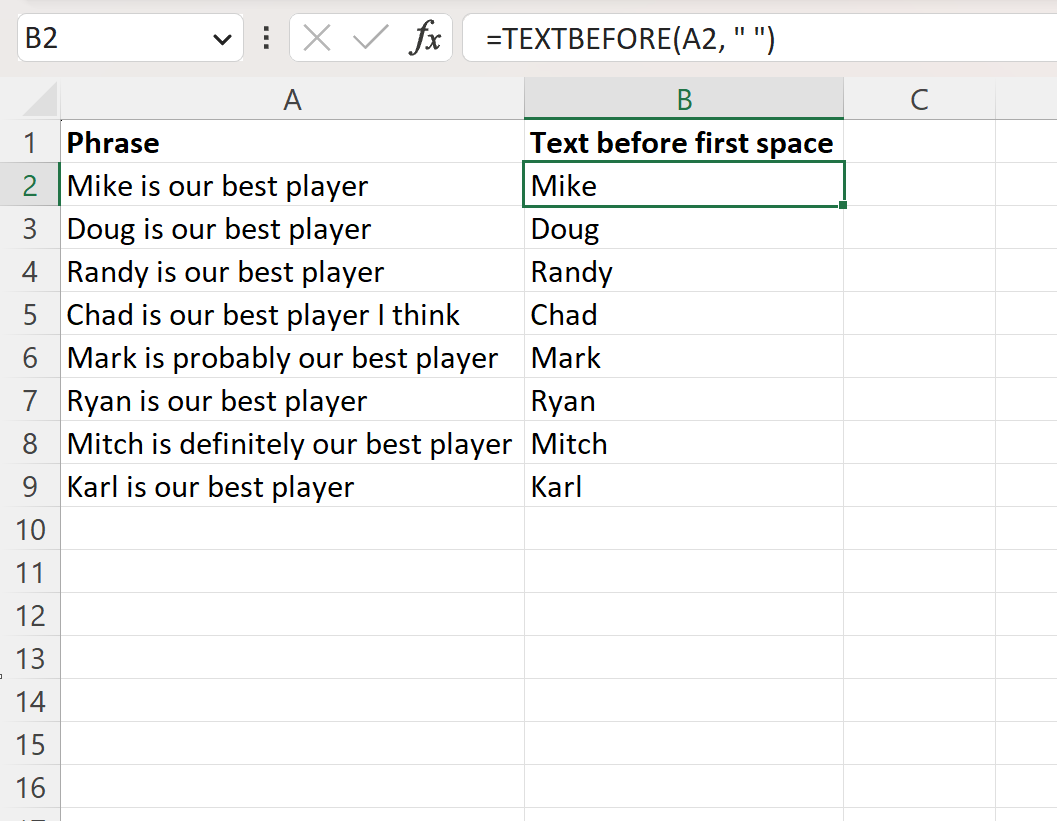
يُعد استخلاص الاسم الأول من حقول الأسماء الثنائية أو الثلاثية من أبرز التطبيقات الوظيفية في إدارة الموارد البشرية والبحوث المسحية. عند الرغبة في عزل الاسم الأول الموجود في الخلية A2، تُصاغ المعادلة بالصورة القياسية:
=TEXTBEFORE(A2, ” “)
تبحث هذه المعادلة عن أول مسافة بيضاء تصادفها في السلسلة النصية، وتقتطع كافة الحروف السابقة لها فوراً، تاركة بقية أجزاء الاسم دون مساس.
ومع ذلك، تبرز مشكلات منهجية عند وجود مسافات بادئة في بداية السجل ناتجة عن أخطاء الإدخال، حيث ستعتبر الدالة تلك المسافة البادئة هي المستهدفة، مما ينتج عنه سلسلة نصية فارغة. لتفادي هذا التشوه وضمان اتساق البيانات، يُوصى بدمج دالة التشذيب المعيارية ضمن المعادلة لتصبح =TEXTBEFORE(TRIM(A2), ” “)، مما يضمن إزالة الشوائب الفراغية قبل تنفيذ الاستقطاع وتعميم الصيغة بثقة عبر السجلات المتتالية.
3.2 استخلاص أسماء المستخدمين من عناوين البريد الإلكتروني
تتضمن قواعد بيانات العملاء وحسابات النظم الرقمية حقول البريد الإلكتروني المكونة بنيوياً من اسم المستخدم متبوعاً برمز آت (@) ثم اسم النطاق الخادم. لعزل اسم المستخدم بصورة نقية دون الحاجة إلى معالجات لاحقة، تُطبق الصيغة المباشرة:
=TEXTBEFORE(A2, “@”)
تتميز هذه المقاربة بكفاءة استثنائية مقارنة بأدوات إكسل الثابتة مثل تحويل النص إلى أعمدة (Text to Columns)، لكون الصيغة ديناميكية وتستجيب تلقائياً لأي تعديل يطرأ على البيانات المصدرية دون تدخل يدوي إضافي.
كما تُسهم هذه الصياغة في الحفاظ على سلامة الحقول وقواعد التدقيق الداخلي، إذ إن ثبات الرمز الفاصل في العناوين المعيارية يحمي النتائج من الانزياح الأفقي الذي قد يطرأ لو استُخدمت أساليب تعتمد على عدد الحروف الثابت، مما يوفر بيئة تنظيف معيارية صالحة لإعداد لوائح المراسلات وتحليل السجلات الرقمية بدقة حسابية عالية.
3.3 فصل الأكواد الوظيفية والبيانات المفصولة بشرطة أو واصلة
تعتمد نظم تخطيط موارد المؤسسات ومستودعات البيانات على هياكل ترميز مدمجة لتعريف المنتجات والوحدات الوظيفية، كأن يُكتب كود المنتج بصيغة “PRD-9842-X1” حيث تشير البادئة إلى الصنف العام. لاستخلاص هذه البادئة التعريفية لعزل المنتجات تبعاً لخطوط إنتاجها، تُستخدم الشرطة كفاصل هيكلي وفق النمط التالي:
=TEXTBEFORE(A2, “-“)
تضمن هذه العملية اقتطاع الجزء التعريفي الأول بدقة صرفة، بصرف النظر عن تباين أطوال الأكواد اللاحقة التي تلي الفاصل.
ينسحب هذا المبدأ التقني على صياغة المعرفات الفريدة للمشاريع الهندسية ومراكز التكلفة المحاسبية التي تستخدم الشرطة السفلية (_) كعلامة تفريق بنيوية. يتيح الاستخراج المنهجي بهذه الصيغ تصنيف القيود المحاسبية وبناء مفاتيح أساسية بديلة (Foreign Keys) لتسهيل الربط بين جداول النماذج المالية والتحليلات الإدارية المتقدمة دون تعقيدات برمجية.
4. تقنيات الاستخراج المتقدمة بالاعتماد على تكرارات متعددة للمحدد
4.1 الاستخراج بالاستناد إلى التكرارات المتقدمة (الظهور الثاني والثالث)
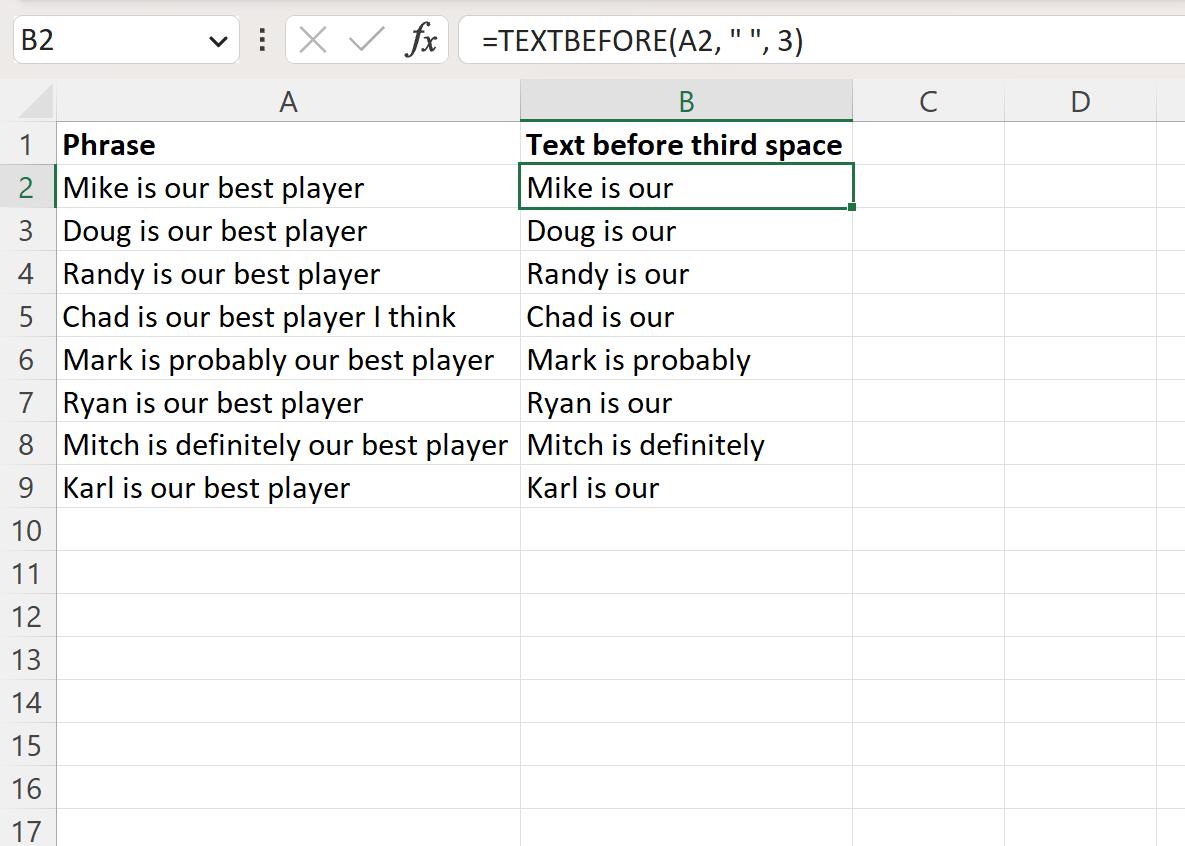
تتطلب السيناريوهات المعقدة أحياناً تجاوز الفاصل الأولي واستخراج كتلة نصية أوسع تنتهي عند فاصل غير مبكر ضمن السلسلة. على سبيل المثال، عند معالجة العناوين الجغرافية المعيارية المدونة بنمط “الدولة – المدينة – الحي – الشارع”، فإن استخراج المقطع الجغرافي الكلي الذي يشمل الدولة والمدينة معاً يقتضي التوقف عند الشرطة الثانية وليس الأولى. يُحقق ذلك بتحديد وسيطة التكرار الموجب بالقيمة 2 عبر الصيغة التالية:
=TEXTBEFORE(A2, ” – “, 2)
تتيح المقارنة التحليلية بين استخراج النص قبل الفاصل الأول وقبل الفاصل الثاني فهماً عميقاً لآليات التحكم في دقة المخرجات. في الحالة الأولى، يُعزل الكيان الفردي الأولي، بينما تتيح الحالة الثانية استخراج تجمعات بنيوية فرعية تحافظ على السياق المكاني أو الهيكلي للبيانات دون الحاجة إلى تفكيك السلسلة إلى أعمدة متعددة ثم إعادة دمجها عبر دوال الربط، مما يوفر خطوات معالجة غير ضرورية ويحد من استهلاك الذاكرة المؤقتة.
4.2 استراتيجيات البحث العكسي لاقتطاع النصوص من النهاية
يبرز التحدي الحسابي الأكبر حين تتفاوت النصوص في عدد المقاطع الداخلية بينما تتوحد في دلالة المقطع الأخير. يظهر هذا جلياً في مسارات الملفات والروابط الحاسوبية مثل “C:UsersAdminDocumentsReportsAnnual_2023.xlsx”؛ حيث تختلف مستويات المجلدات تبعاً لعمق المسار الرقمي، ولكن المطلوب دائماً هو استخراج مسار المجلد الحاضن باستثناء اسم الملف وامتداده الأخير. لمواجهة هذا التباين، تُوظف وسيطة التكرار السالب بالقيمة (-1) بالشكل الآتي:
=TEXTBEFORE(A2, “”, -1)
تبدأ الخوارزمية في هذه الحالة بالمسح من نهاية الخلية باتجاه اليمين حتى تعثر على أول شرطة مائلة من جهة النهاية، وتقتطع كل ما يسبقها بالكامل. تحل هذه الاستراتيجية العكسية معضلة النصوص متغيرة الأطوال ذات التكرارات غير المنتظمة؛ إذ تضمن ثبات نقطة الاقتطاع دون حاجة لحساب إجمالي عدد الفواصل في السلسلة النصية عبر دوال معقدة، وهو ما يمثل طفرة منهجية مقارنة بالأساليب الكلاسيكية.
4.3 معالجة النصوص المتداخلة ذات المحددات المتكررة المتتابعة
تتسبب عمليات تصدير البيانات الرديئة أحياناً في توليد سلاسل نصية تحتوي على محددات متطابقة متجاورة، مثل وجود مسافتين متتاليتين أو شرطتين متعاقبتين (“A–B”). عند تطبيق دالة TEXTBEFORE باستهداف التكرار الثاني على هذا النوع من المدخلات، قد تكون النتيجة مفاجئة للمحلل غير المتمرس؛ إذ ستتعامل الخوارزمية مع الفراغ المنعدم بين الرمزين كقيمة نصية فارغة، فتستخرج النص الواقع قبل الفاصل الثاني والذي قد يبدو متضمناً للفاصل الأول فقط.
للتعامل مع هذا التداخل الدلالي، يجب تطبيق استراتيجيات التنقية المسبقة لتطهير السلاسل قبل تمريرها للاستقطاع. يمكن استخدام دالة SUBSTITUTE لاستبدال المحددات المزدوجة بمحدد أحادي منظم، أو توظيف دوال التدقيق المنطقي لتقييم صحة المخرجات الناتجة. يضمن هذا النهج عدم وجود فواصل وهمية تشوه الأبعاد الإحصائية وتؤدي إلى تصنيفات خاطئة في مراحل التحليل اللاحقة.
5. إدارة الأخطاء والحالات الشاذة في عمليات الاستقطاع النصي
5.1 تحليل أسباب ظهور خطأ القيمة غير المتاحة (#N/A)
تُعد رسالة الخطأ #N/A الاستجابة النظامية الافتراضية لدالة TEXTBEFORE عندما تعجز خوارزمية البحث عن مطابقة المحدد المطلوب داخل السلسلة النصية المصدر. يحدث هذا عندما يخلو السجل تماماً من الرمز المبحوث عنه، كأن يُطلب استخراج النص قبل الفاصلة من سجل لا يتضمن أي فاصلة، أو عند طلب تكرار يتجاوز التكرارات الفعلية الموجودة في الخلية، كطلب التكرار الثالث لمحدد لا يتكرر سوى مرة واحدة فقط.
من الأهمية بمكان التفرقة المنهجية بين الأخطاء الناجمة عن غياب الحرف الفاصل كلياً وتلك الناتجة عن تعارض حساسية حالة الأحرف؛ فالبحث عن حرف صغير “a” في كلمة لا تحتوي إلا على الحرف الكبير “A” سيُطلق خطأ #N/A طالما كانت وسيطة [match_mode] مضبوطة على قيمتها الافتراضية الصارمة. إن فهم هذه المسببات يقي المحلل من استنتاجات خاطئة حول سلامة البيانات ويحدد مسارات التصحيح المطلوبة بدقة.
5.2 التوظيف الأمثل لوسيطة القيمة البديلة (if_not_found)
وفر مهندسو مايكروسوفت حلاً بنيوياً استباقياً لمعالجة أخطاء الفقد عبر الوسيطة السادسة الاختيارية [if_not_found]، مما يغني تماماً عن استخدام دوال التحقق الخارجية في كثير من الحالات. يمكن توظيف هذه الوسيطة لإعادة النص الأصلي كاملاً إذا لم يتم العثور على الفاصل، بدلاً من إرجاع رسالة خطأ صريحة، وذلك عبر الصيغة التالية:
=TEXTBEFORE(A2, “-“, , , , A2)
تُسهم هذه المقاربة في بناء نماذج عمل تتسم بالمرونة؛ حيث يمكن للمحلل تخصيص نصوص توجيهية كبدائل، مثل كتابة “المحدد غير موجود”، أو إرجاع سلسلة فارغة “” لتفادي إرباك لوحات التحكم والمخططات البيانية بالرموز الحمراء أو رسائل التنبيه النظامية. يحافظ هذا الإجراء على نظافة التقارير النهائية ويضمن استمرار العمليات الحسابية المرتبطة دون انقطاع تشغيلي.
5.3 التكامل الوقائي مع دوال التحقق المساعدة (IFERROR و ISNA)
على الرغم من فاعلية وسيطة [if_not_found]، إلا أن بناء النظم التحليلية المؤسسية ذات المتطلبات الرقابية الصارمة قد يستدعي إنشاء طبقة حماية إضافية بالاعتماد على دوال متخصصة مثل IFERROR أو ISNA. تُغلف الدالة الأصلية بصيغة وقائية لمعالجة ليس فقط أخطاء عدم العثور، بل وأي انقطاع مفاجئ في المراجع الحسابية أو أخطاء التنسيق البرمجي غير المتوقعة:
=IFERROR(TEXTBEFORE(A2, “-“), “قيمة غير صالحة”)
توضح التحليلات الحوسبية أن الاعتماد على الوسيطة المدمجة للدالة يُعد أكثر كفاءة في استهلاك الذاكرة وسرعة المعالجة مقارنة بتعشيش دالة IFERROR المحيطة، نظراً لأن الوسيطة المدمجة تُعالج ضمن الدورة الحسابية الداخلية لنفس الخوارزمية دون استدعاء مكدس دوال إضافي. ومع ذلك، يظل استخدام IFERROR واجباً برمجياً عندما يرتبط الاستخراج النصي ببيئات قد تعاني من عدم اتساق مراجع الخلايا أو تلف في مصفوفات الإدخال، لضمان استدامة النموذج وسلامته الرياضية.
6. المنهجية البديلة: استخراج النصوص باستخدام الدوال التقليدية (الإصدارات القديمة)
6.1 الجمع الرياضي بين دالتي LEFT و SEARCH
في بيئات العمل التي تعتمد على إصدارات إكسل القديمة (مثل Excel 2019 وما قبله)، تبرز الصيغة الكلاسيكية القائمة على الجمع الجبري بين دالتي LEFT و SEARCH كحل تاريخي معتمد لاستقطاع النصوص قبل فاصل محدد. تُصاغ هذه المعادلة المعيارية على النحو التالي:
=LEFT(A2, SEARCH(“-“, A2) – 1)
تقوم خوارزمية دالة SEARCH بحساب الموضع الرقمي للرمز المستهدف بدءاً من الخانة الأولى، معيدة مؤشراً عددياً يمثل ترتيب الفاصل داخل السلسلة.
يكتسب طرح القيمة العددية (1) من ناتج البحث أهمية رياضية قصوى؛ فدالة SEARCH تعيد موقع الرمز نفسه، وبالتالي فإن تمرير هذا الرقم مباشرة لدالة LEFT سيؤدي إلى اقتطاع النص متضمناً المحدد الفاصل في نهايته. يحقق الطرح الحسابي ضبطاً لطول النص المستخرج ليتوقف تماماً عند الحرف السابق للفاصل مباشرة، وهو ما يعزل المقطع المطلوب بنقاء هيكلي تام وفق متطلبات التطهير النصي.
6.2 الفرق الدقيق بين دالتي SEARCH و FIND في تحديد المواضع
يخلط كثير من المستخدمين بين دالتي SEARCH و FIND نظراً لتقارب وظيفتهما الظاهرية، إلا أن هناك فروقاً دقيقة وحاسمة تحكم استخدام كل منهما. تتميز دالة FIND بحساسيتها المطلقة لحالة الأحرف (Case-Sensitive) وعدم دعمها لأي من محارف البدل التوسيعية، مما يجعلها الأداة المناسبة للاستعلام عن الرموز الصارمة والتعامل مع اللغات اللاتينية عندما تكون التفرقة بين الحروف الكبيرة والصغيرة أمراً إلزامياً لتمييز المقاطع الدلالية.
في المقابل، تتسم دالة SEARCH بمرونة تشغيلية؛ فهي غير حساسة إطلاقاً لحالة الأحرف، وتدعم استخدام محارف البدل مثل علامة الاستفهام (?) للدلالة على محرف فردي مجهول، والنجمة (*) للدلالة على تتابع عشوائي من المحارف. يفرض هذا التباين على المحلل اختيار الأداة المتوافقة بدقة مع طبيعة البيانات؛ فتجاهل الفروق قد يؤدي إلى أخطاء #VALUE! المتكررة في حال فشل دالة FIND في العثور على الحرف بحالته المطابقة تماماً.
6.3 مقارنة معيارية في الكفاءة والتعقيد بين الأسلوبين التقليدي والحديث
تُظهر المقارنة التحليلية بين المنهجية الحديثة والتركيبة الكلاسيكية تبايناً جوهرياً في سهولة القراءة البرمجية وتكاليف الصيانة الدورية. فبينما تتطلب تركيبة LEFT مع SEARCH استدعاء دالتين وإجراء عملية طرح جبرية وتغليفها بدالة IFERROR لتفادي الانهيار عند غياب الرمز، تنجز دالة TEXTBEFORE المهمة ذاتها بصيغة واحدة مباشرة وواضحة المعالم، مما يرفع من مقروئية النماذج للمدققين الخارجيين.
على صعيد الحمل الحسابي، أثبتت الاختبارات المعيارية على قواعد بيانات تضم مئات الآلاف من الصفوف أن دالة TEXTBEFORE تستهلك وقتاً حوسبياً أقل بنسبة ملحوظة، نظراً لتنفيذ المسح والاقتطاع في مسار داخلي موحد بدلاً من نقل المؤشرات الحسابية بين دالتين منفصلتين. ومع ذلك، تظل الصيغة الكلاسيكية محتفظة بقيمتها التقنية الحتمية في المؤسسات التي تتطلب نماذجها توافقاً رجعياً شاملاً مع مختلف إصدارات إكسل التاريخية لضمان استمرارية التشغيل دون أخطاء غير معروفة.
7. التعامل مع المحددات المتعددة والشروط المركبة
7.1 تمرير ثوابت المصفوفات لاستهداف فواصل بديلة متعددة
تواجه عمليات تكامل البيانات مشكلة عدم تجانس المحددات المستخدمة داخل العمود الواحد، كأن تتضمن بعض السجلات شرطة (-) وأخرى فاصلة مائلة (/) أو فاصلة عادية (،). لمعالجة هذا التشتت دفعة واحدة، تتيح دالة TEXTBEFORE تمرير ثابت مصفوفي (Array Constant) يضم قائمة بجميع الفواصل المحتملة باستخدام الأقواس المعقوفة على النحو التالي:
=TEXTBEFORE(A2, {“-“, “/”, “,”})
تتعامل الخوارزمية مع هذه المصفوفة بمنطق البدائل الشرطية المتزامنة.
يقوم محرك الدالة بمسح النص والتقاط أول محدد يظهر في السلسلة النصية من بين الرموز المضمنة في المصفوفة، وتطبيق الاقتطاع عنده مباشرة وتجاهل بقية الاحتمالات اللاحقة. يوفر هذا الأسلوب حلاً فعالاً لتنظيف البيانات المجمعة من استطلاعات رأي متعددة أو مصادر إدخال متباينة التنسيق دون الحاجة لبناء سلاسل شرطية طويلة من دوال IF المتداخلة، مما يختزل زمن المعالجة ويحفظ اتساق المنطق البرمجي.
7.2 التحكم في حساسية الأحرف للمحددات الأبجدية
عندما لا يكون المحدد رمزاً حسابياً بل مقطعاً لفظياً أو كلمة فرعية مثل “CODE” أو “Item”، تكتسب وسيطة [match_mode] أهمية محورية للتحكم في معايير الاستخراج. إذا كانت البيانات مدخلة بنمط غير موحد يجمع بين كتابة المقطع بحروف كبيرة تارة وحروف صغيرة تارة أخرى، فإن الصيغة التالية تضمن المطابقة بغض النظر عن طريقة الكتابة:
=TEXTBEFORE(A2, “code”, , 1)
تضمن القيمة (1) تعطيل حساسية الأحرف لدى محرك الفحص، مما يتيح له مطابقة “CODE” و”Code” و”code” كفواصل صالحة.
تُسهم هذه المرونة في معالجة الانحرافات الناتجة عن أخطاء الإدخال البشري غير المنضبط، خاصة في بيئات جمع البيانات الميدانية والاستبانات الإلكترونية المفتوحة. إن تحييد حساسية الأحرف يحمي النماذج من استبعاد سجلات صحيحة وظيفياً ولكنها تختلف في التنسيق الشكلي، مما يعزز اكتمال العينات الإحصائية ويقلل من الحاجة إلى تدخلات يدوية لتعديل النصوص المصدرية.
7.3 معالجة النصوص ثنائية اللغة وتحديات اتجاه القراءة (RTL/LTR)
يفرض خلط النصوص العربية مع اللغات اللاتينية أو الرموز الترقيمية تحديات تقنية معقدة ترتبط باختلاف اتجاه القراءة البصري عن الترتيب المنطقي لتخزين الحروف في الذاكرة الرقمية. في النصوص المكتوبة من اليمين إلى اليسار (RTL)، قد يظهر الرمز الفاصل بصرياً في نهاية السطر بينما هو مخزن حوسبياً كأول محرف في السلسلة النصية، مما يسبب التباساً عند محاولة تحديد اتجاه الاقتطاع الصحيح.
تتعامل دالة TEXTBEFORE مع النصوص وفق ترتيبها المنطقي (Logical Order) المخزن في ذاكرة النظام وليس وفق مظهرها البصري على الشاشة. لضمان دقة الاقتطاع دون حدوث انقلاب في ترتيب الحروف المستخلصة، يجب التأكد من عدم وجود محارف توجيه خفية (مثل محارف التحكم في اتجاه النص ثنائي الاتجاه)، واستخدام دوال التدقيق النصي لعزل المقاطع العربية بدقة وتفادي التشوهات البصرية الناتجة عن تداخل المحارف الترقيمية بين اللغات المختلفة.
8. الاندماج الوظيفي لدالة TEXTBEFORE مع الدوال النصية والديناميكية الأخرى
8.1 التكامل مع دالتي TEXTAFTER و MID للحصول على مقاطع وسيطة
تتجاوز الاحتياجات التحليلية المتقدمة مجرد استخراج الأطراف لتصل إلى استخلاص مقاطع نصية وسيطة تقع بدقة متناهية بين محددين مختلفين داخل السجل الواحد. يمكن تحقيق هذا الحصر الهندسي عبر دمج متكامل بين دالتي TEXTBEFORE و TEXTAFTER داخل صيغة واحدة دون الحاجة لأي أعمدة مساعدة، على النحو الموضح في المعادلة التالية:
=TEXTBEFORE(TEXTAFTER(A2, “[“), “]”)
تقوم دالة TEXTAFTER أولاً باقتطاع كل ما يقع بعد القوس المفتوح، ثم تتولى دالة TEXTBEFORE اقتطاع ما يسبق القوس المغلق من الناتج المؤقت، مما يعزل القيمة المحصورة بين القوسين بضربة برمجية موحدة.
يحل هذا التعشيش محل التركيبات المعقدة لدالة MID التاريخية التي كانت تتطلب حسابات موضعية متعددة لأماكن البداية والنهاية عبر دالتي SEARCH متتاليتين وطرح الفروق بينهما. يقلل هذا التكامل الحديث من أخطاء الإزاحة الحسابية بمقدار محرف واحد، ويؤسس لنمط برمجي مرن يمكن تعميمه لاستخراج البيانات الوصفية المضمنة داخل النصوص المركبة بموثوقية حسابية عالية.
8.2 الاقتران بدوال التنقية والتشذيب TRIM و CLEAN
نادراً ما تأتي البيانات النصية المستوردة بصيغة نقية؛ إذ غالباً ما تصاحبها محارف غير قابلة للطباعة ناتجة عن التحويل من أنظمة قديمة، أو مسافات بيضاء غير مرئية تؤدي إلى كسر خوارزميات المطابقة الدقيقة. لتفادي هذه المشكلات، يُعتبر اقتران دوال الاستقطاع بدوال التنقية والتشذيب مثل TRIM و CLEAN خطوة تأسيسية لا غنى عنها في هندسة خطوط معالجة وتطهير البيانات المتقدمة.
تعمل دالة CLEAN على التخلص من المحارف غير القابلة للطباعة (أكواد ASCII من 0 إلى 31)، بينما تتولى دالة TRIM إزالة المسافات الزائدة في البدايات والنهايات وتوحيد المسافات البينية لتصبح مسافة واحدة فقط. عند تغليف النصوص بهذه الدوال قبل تمريرها لدالة TEXTBEFORE كما في الصيغة =TEXTBEFORE(TRIM(CLEAN(A2)), “-“)، يُبنى جدار حماية برمجي يمنع المحددات الوهمية من تعطيل البحث ويضمن خروج نصوص نقية صالحة للربط الحسابي والتحليل المتقدم.
8.3 توليد المصفوفات الانسكابية الديناميكية عبر النطاقات الكاملة
تتمتع دالة TEXTBEFORE بدعم كامل لمعمارية المصفوفات الديناميكية (Dynamic Arrays)، مما يمكنها من معالجة نطاقات كاملة وتوليد نتائج منسكبة تلقائياً بضغطة زر واحدة. بدلاً من كتابة الصيغة لخلية واحدة وسحب مقبض التعبئة يدوياً عبر آلاف الصفوف، يمكن تمرير نطاق كامل كوسيطة نصية أولى على النحو التالي:
=TEXTBEFORE(A2:A500, ” “)
تنسكب النتائج المستخلصة تلقائياً عبر الخلايا المقابلة دون الحاجة لتكرار إدخال الصيغ.
يستلزم توظيف هذه الميزة إدارة واعية للمساحات الحسابية في أوراق العمل؛ إذ يتطلب الانسكاب خلو النطاق المستهدف من أي بيانات أو نصوص مسبقة، وإلا سيتعطل المحرك الحسابي ويُطلق خطأ الانسكاب الشهير #SPILL!. يوفر الانسكاب ميزة جوهرية تتمثل في التحديث التلقائي لكافة السجلات بالتزامن، وتقليص حجم ملف المصنف بشكل هائل لكون المعادلة مخزنة برمجياً في الخلية الرئيسية الأولى فقط، مما يرفع من كفاءة إدارة النماذج الضخمة.
9. تطبيقات قطاعية متقدمة ودراسات حالة واقعية
9.1 تحليل سجلات الخوادم والروابط الرقمية (URLs)
يمثل تحليل السجلات الرقمية وفك تشفير الروابط الإلكترونية في قطاع تقنية المعلومات بيئة خصبة لتطبيقات التجزئة النصية المعقدة، وهو ما يرتبط بتقنيات استخلاص الأنماط من البيانات غير المهيكلة واسترجاع المعلومات بكفاءة (Lian et al., 2023). فعند تفكيك عناوين الويب لاستخلاص بروتوكول الاتصال أو النطاق الأساسي قبل مسارات المعلمات الشرطية المتغيرة، توفر دالة TEXTBEFORE وسيلة مباشرة لعزل المعرفات الرقمية ومعلمات التتبع الإحصائي عبر استهداف علامات التوقف الخاصة مثل علامة الاستفهام أو الشرطة المائلة المزدوجة:
=TEXTBEFORE(A2, “://”)
تقتطع هذه المعادلة بروتوكول الاتصال (مثل “https”) بدقة متناهية من سجلات خوادم الويب.
في دراسة تطبيقية على سجلات الخوادم اليومية (Server Log Files) المكونة من ملايين الأسطر، يمكن تفكيك عناوين IP والأختام الزمنية المدمجة في سلاسل نصية طويلة عبر تمرير الفواصل الزمنية المعتمدة، مما يتيح لمهندسي النظم عزل المكونات التشغيلية بدقة تمهيداً لتطبيق خوارزميات كشف الاختراق وحساب معدلات التردد الرقمي دون الحاجة إلى أدوات معالجة خارجية.
9.2 تنظيم السجلات الأكاديمية والبيانات الديموغرافية للبحوث
تواجه الجامعات والمؤسسات البحثية تحديات دائمة في إدارة سجلات الباحثين والطلاب نتيجة تداخل الألقاب الأكاديمية والدرجات العلمية مع الأسماء الشخصية في قواعد البيانات. لفصل اللقب الأكاديمي (مثل “دكتور” أو “أستاذ”) عن الاسم في سجل مدون بصيغة “د. أحمد خليل – قسم الحاسب”، يمكن تطبيق الدالة لعزل الاسم مع الحفاظ على مرونة التكرارات:
=TEXTBEFORE(A2, ” – “)
يضمن هذا الفصل فرز السجلات تبعاً للأسماء المجردة أو تصنيفها لاحقاً بشكل مستقل.
يمتد هذا الإجراء المنهجي إلى معالجة أكواد المقررات الأكاديمية المركبة (مثل “CS101-Intro”)، حيث يُستخرج رمز القسم عبر عزل المقطع السابق للشرطة لمطابقته مع اللوائح الدراسية. في الأبحاث المسحية والدراسات الاجتماعية، يسهم توحيد معايير إدخال بيانات المشاركين وعزل المتغيرات الديموغرافية المدمجة في رفع موثوقية التحليلات الإحصائية، وضمان خلو العينات من التداخلات النصية التي قد تفسد نتائج النمذجة الرياضية اللاحقة.
9.3 معالجة المعاملات المالية وأكواد الفواتير التجارية
تعتمد الإدارات المالية في المؤسسات التجارية على دفاتر الأستاذ العام وأنظمة تخطيط الموارد التي تصدر أرقام قيود وفواتير مدمجة تتضمن مركز التكلفة، ورقم الحساب، وسنة المعاملة مفصولة بنقاط أو شرطات مثل “101.4500.2023.INV”. لمطابقة هذه السجلات بدقة، يستلزم الأمر عزل بادئة الحساب المالي الممثلة في أول مقطعين عبر استهداف النقطة الثانية كمحدد للاقتطاع:
=TEXTBEFORE(A2, “.”, 2)
تسمح هذه العملية بتجميع النفقات وفق مراكز التكلفة الرئيسية قبل الدخول في تفاصيل الفواتير الفرعية.
كذلك تتيح هذه التقنية استخراج التواريخ المدمجة داخل أرقام الحركات المحاسبية للمطابقة مع الكشوفات المصرفية المستوردة. إن أتمتة هذه العمليات يقلل بشكل ملموس من فترات الإغلاق المالي الشهري، ويحمي النماذج المحاسبية من أخطاء النقل اليدوي، مما يوفر بيئة رقابية متينة تلبي معايير التدقيق المالي الداخلي والخارجي بكفاءة تشغيلية عالية.
10. المعايير المنهجية المثلى لتحسين الأداء وحوكمة النماذج الحسابية
10.1 تحسين كفاءة الحوسبة في مصنفات البيانات الضخمة
يفرض التعامل مع مصنفات العمل الضخمة التي تحتوي على مئات الآلاف من السجلات متطلبات حوسبية صارمة لإدارة موارد وحدة المعالجة المركزية (CPU) والذاكرة العشوائية. إن تكرار تطبيق الدوال النصية عبر ملايين الخلايا قد يولد فترات استجابة طويلة وتأخيراً ملحوظاً في عمليات إعادة الحساب (Recalculation)، مما يستدعي التخلص الصارم من المراجع الدائرية والاعتماديات الحسابية المتشعبة التي تثقل كاهل المحرك الحسابي للبرنامج.
يُعد تفضيل استخدام جداول إكسل المنظمة (Excel Tables) من أهم الممارسات لتحسين الكفاءة؛ حيث تتيح مراجع البنية المهيكلة (Structured References) للدوال النصية التوسع والانكماش التلقائي مع تغير حجم البيانات، دون الحاجة للإشارة إلى أعمدة كاملة (مثل A:A) التي تجبر البرنامج على فحص أكثر من مليون خلية. تضمن هذه الإدارة الحوسبية الرشيدة تقليص استهلاك الموارد وتسريع زمن الاستجابة في النماذج التفاعلية المعقدة.
10.2 التوثيق البرمجي ومقروئية الصيغ الحسابية للمستخدمين
تكتسب مقروئية الصيغ الحسابية أهمية محورية لضمان استدامة النماذج وتسهيل عمليات التدقيق والمراجعة التي يقوم بها محللون آخرون. يُعد دمج دالة LET المعيارية مع الدوال النصية نقلة نوعية في هذا المضمار؛ إذ تتيح تعريف متغيرات وسيطة تحمل أسماء ذات دلالة واضحة، وتمنع تكرار تقييم السلسلة النصية ذاتها أكثر من مرة داخل المعادلة الواحدة، كما يتضح في الصيغة الهندسية التالية:
=LET(SourceText, TRIM(A2), Delim, “-“, TEXTBEFORE(SourceText, Delim, 1, 0, 0, SourceText))
يختزل هذا الهيكل تكرار الدوال المساعدة ويوضح تدفق البيانات بسلاسة.
إلى جانب ذلك، يجب إدراج تعليقات توضيحية داخل مصنفات العمل واستخدام النطاقات المسماة (Named Ranges) كبديل للمراجع الرقمية الثابتة غير المعبرة. يُسهم التوثيق البرمجي المنظم في خفض تكاليف الصيانة وتسهيل نقل المعرفة بين فرق العمل التحليلية، ويحول النماذج المحاسبية والإحصائية من شفرات غامضة إلى منظومات عمل مؤسسية تتسم بالشفافية وقابلية التدقيق المستمر.
10.3 التوافقية وضمان استدامة البيانات عبر بيئات التشغيل المختلفة
تمثل حوكمة البيانات ضمان عمل النماذج بكفاءة عبر مختلف المنصات والبيئات التشغيلية للمستفيدين. نظراً لأن دالة TEXTBEFORE تتطلب إصدارات حديثة تدعم محرك المصفوفات الديناميكية (Microsoft 365 أو Excel للويب)، فإن مشاركة المصنفات مع مستخدمين يعتمدون على إصدارات مكتبية قديمة أو حزم برمجية منافسة قد تؤدي إلى ظهور خطأ الاسم غير المعرف (#NAME?)، مما يكسر السلسلة الحسابية للنموذج بالكامل.
لإدارة هذا الخطر التوافقي، ينبغي تبني بروتوكول صارم يتضمن تقييم البيئات المستهدفة قبل اعتماد الدوال الحديثة؛ فإذا كان التوافق الرجعي إلزامياً، يتم اللجوء إلى الصيغ المركبة الكلاسيكية المدعمة ببدائل الحماية. أما في التقارير النهائية الموجهة للإدارة، فيُفضل تحويل القيم المحسوبة مؤقتاً إلى نصوص ثابتة (Values Pasting) لضمان استقرار العرض التقديمي وثبات البيانات الرقمية دون أي اعتماد على محركات الحساب الخارجية، مما يضمن استدامة التحليل وحصانته ضد تقلبات البيئات البرمجية المتعددة.
خاتمة
استعرض هذا المقال الموسع الأسس العلمية والتطبيقية لاستخراج النصوص قبل المحددات في مايكروسوفت إكسل، مسلطاً الضوء على النقلة المعمارية التي مثّلها تدشين دالة TEXTBEFORE مقارنة بالحلول التقليدية المركبة. إن فهم الخصائص الدلالية لوسائط الدالة—بدءاً من التحكم في أرقام التكرار والتوجيه العكسي، مروراً بحساسية الأحرف وحالات الانتهاء، ووصولاً إلى إدارة الأخطاء عبر المعاملات البديلة المدمجة—يُمكّن المحللين من بناء نماذج معالجة تتسم بالدقة الرياضية والصلابة التشغيلية، فضلاً عن خفض التكلفة الحوسبية والصيانة المستمرة.
يتبين من خلال المقارنات المعيارية والحالات التطبيقية أن اختيار المنهجية المناسبة يجب أن يسترشد بطبيعة البيانات، وحجم السجلات، ومتطلبات التوافقية الرجعية للنظم المؤسسية. إن دمج هذه التقنيات النصية ضمن خطوط معالجة متكاملة مقترنة بدوال التشذيب وتوليد المصفوفات الانسكابية الديناميكية يُعد ركيزة أساسية لتحويل البيانات الأولية غير المهيكلة إلى معلومات رقمية نقية، تدعم اتخاذ القرارات الإدارية والاستثمارية المستندة إلى أسس تحليلية موثوقة.
المراجع
- Lankton, N. K., McKnight, D. H., & Tripp, J. F. (2015). Technology, Humanness, and Trust: Rethinking Trust in Technology. Journal of the Association for Information Systems. https://doi.org/10.17705/1jais.00411
- Lian, H., Lu, C., Li, S., Zhao, Y. D., Tang, C., & Zong, Y. (2023). A Survey of Deep Learning-Based Multimodal Emotion Recognition: Speech, Text, and Face. Entropy. https://doi.org/10.3390/e25101440
- Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction. https://doi.org/10.1016/s0959-4752(01)00016-0