
تُعد معالجة النصوص والسلاسل المحرفية (String Manipulation) في جداول بيانات جوجل (Google Sheets) ركيزة جوهرية من ركائز إعداد وتنقية البيانات في البحوث الأكاديمية والتحليلات الإحصائية المعاصرة. ورغم أن برمجيات الجداول الحسابية أُنشئت في الأصل للتعامل مع العمليات المحاسبية والمصفوفات الرقمية منذ ظهور النظم الأولى مثل فيزيكالك (VisiCalc) ولوتس 1-2-3 وصولاً إلى إطلاق جداول بيانات جوجل في عام 2006، إلا أن التطور المتسارع في مجالات تحليل المحتوى والعلوم السلوكية واللغويات الحاسوبية فرض ضرورة استنطاق الحقول النصية غير المهيكلة واستخراج مؤشرات كمية دقيقة من داخلها. إن احتساب تكرار محرف معين داخل خلية أو نطاق من الخلايا ليس مجرد مهارة تقنية عابرة، بل هو إجراء منهجي بالغ الحساسية يرتبط مباشرة بموثوقية القياس وسلامة الاستدلال الإحصائي في الأبحاث التي تعتمد على ترميز المتغيرات النوعية.
تكمن الصعوبة التقنية في جداول بيانات جوجل في عدم وجود دالة قياسية أحادية ومباشرة تحمل اسماً تقليدياً مثل “COUNTCHAR”، مما يدفع الباحثين ومحللي البيانات إلى اللجوء إلى التركيب الخوارزمي والتوليف المنطقي بين الدوال الرياضية والنصية المتاحة. يعتمد هذا التوليف على بناء نماذج طرح تفاضلية تقيس التغير في طول السلسلة المحرفية قبل وبعد استبعاد الرمز المستهدف، أو استخدام محركات التعبيرات النمطية (Regular Expressions) المتقدمة. تتيح هذه المقاربات الرياضية تفكيك النصوص المعقدة إلى وحداتها الأولية، مما يخدم تطبيقات متعددة تبدأ من تنظيف قواعد البيانات الضخمة وفحص اتساق الرموز المعيارية، وتصل إلى استخراج ملامح المشاعر والأنماط التعبيرية في أبحاث العلوم الاجتماعية.
يهدف هذا الدليل المنهجي الموسع إلى تقديم تشريح أكاديمي شامل وغير مسبوق لكافة آليات وخوارزميات حساب عدد الأحرف المعينة في جداول بيانات جوجل. سنتناول بالدراسة المعمقة النموذج الرياضي الأساسي المعتمد على دالتي الطول والاستبدال، والتمييز الدقيق بين الصيغ الحساسة لحالة الأحرف (Case-Sensitive) والصيغ غير الحساسة لها (Case-Insensitive)، والتوسيع المصفوفي للتعامل مع النطاقات الكبرى، وتفكيك المقاطع متعددة المحارف والرموز الخاصة، مع ربط كل ذلك بالممارسات المنهجية لإدارة وتنظيف البيانات في البيئات البحثية المتطورة.
1. مقدمة منهجية لتحليل النصوص وحساب الأحرف في جداول بيانات جوجل
1.1 أهمية التحليل الكمي للمحارف داخل حقول البيانات
يشكل التحليل الكمي للمحارف والرموز حجر الزاوية في ضبط جودة البيانات المدخلة وتوثيقها وفق المعايير العلمية الصارمة. ففي سياق إدارة البيانات، غالباً ما تحتوي السجلات على حقول هجينة تدمج بين النصوص والأرقام والرموز الاصطلاحية مثل الشرطات والفواصل والنقاط، والتي تعبر عن معرفات فريدة أو تصنيفات فرعية. إن التأكد من احتواء حقل معين على عدد محدد من الرموز الفاصلة يمثل خطوة أساسية للتحقق من صحة البنية البنائية للبيانات (Structural Integrity)، ومن ثم ضمان عدم حدوث أخطاء أثناء تصدير هذه الحقول إلى حزم التحليل الإحصائي المتقدمة.
تتجلى الحاجة الإحصائية لاستخراج وتتبع تكرار رموز محددة عند التعامل مع المتغيرات النوعية والتصنيفية. فعلى سبيل المثال، في الاستبيانات المفتوحة أو المسوح الميدانية الرقمية، يلجأ الباحثون إلى احتساب تكرار علامات الترقيم الانفعالية (مثل علامات التعجب أو الاستفهام) أو حروف معينة لتقدير كثافة الانفعال أو نبرة النصوص المحللة. وقد أشار أليكس بولتون ونينا فياتكينا (Boulton & Vyatkina, 2021) إلى أن التعلم الموجه بالبيانات وتحليل المتون اللغوية يستلزم في كثير من الأحيان تجزئة النصوص المكتوبة بدقة متناهية لحساب الترددات النسبية للوحدات اللغوية الصغرى، مما يؤكد أن التعامل مع الأحرف كمفردات إحصائية يمثل مدخلاً رئيساً لفهم البنى التعبيرية.
علاوة على ذلك، يمتد تطبيق تكرار الرموز إلى مجالات أرشفة الاستبيانات وتحليل المحتوى السلوكي واللغوي على منصات التواصل الاجتماعي؛ إذ يتطلب فحص المنشورات الرقمية وتصنيفها رصد تكرار الرموز التعبيرية أو وسوم معينة ومقارنتها بالمتغيرات السلوكية للأفراد، كما يتضح في دراسات تحليل أثر استخدام المنصات والتطبيقات على التفاعل البشري وسلوكيات المستخدمين (Honary et al., 2019). وبالمثل، في الدراسات المعجمية المعقدة التي تختبر سرعة التعرف على الكلمات المركبة وخصائصها المحرفية (Tse et al., 2016)، يُعد الحساب الدقيق لعدد المحارف المشتركة أو المحددة عاملاً حاسماً في نمذجة زمن الاستجابة والأداء المعرفي.
1.2 التحديات الهيكلية في معالجة السلاسل النصية (Strings)
تنبع الصعوبة الأساسية في معالجة السلاسل النصية داخل جداول البيانات من التباين الهيكلي الجوهري بين محركات الحساب الرقمي ومحركات معالجة الكتل النصية غير المهيكلة. صُممت الدوال الإحصائية التقليدية في جداول بيانات جوجل للتعامل مع قيم عددية مستقلة موزعة عبر خلايا متباينة؛ في المقابل، تُعامل النصوص كسلاسل مدمجة من الرموز (Arrays of Characters) المحكومة بنظام ترميز موحد (مثل Unicode/UTF-8)، مما يجعل النفاذ إلى مكوناتها الفرعية يتطلب مسحاً تكرارياً متسلسلاً لكل رمز على حدة، وهو ما لا تتيحه الدوال الحسابية المباشرة.
تتمثل إحدى أبرز الإشكاليات التقنية في الحساسية الصارمة لحالة الأحرف اللاتينية (Case Sensitivity)؛ حيث يمتلك الحرف الصغير (مثل “a”) شفرة حوسبية تختلف تماماً عن شفرة الحرف الكبير (مثل “A”). إن هذا التباين الشفري يفرض تحديات جمة عند محاولة توحيد المقاييس الإحصائية؛ إذ قد يؤدي الإغفال عن حالة الحرف إلى تشويه النتائج وتخفيض التكرار المحسوب للمتغيرات إلى النصف في بعض الدراسات النصية، ما لم يتم تحييد هذا العامل عبر دوال وسيطة متخصصة.
من الأخطاء المنهجية الشائعة بين مستخدمي جداول البيانات الاعتقاد بإمكانية استخدام دالة العد الشرطي التقليدية COUNTIF لحساب عدد تكرار حرف معين داخل خلية. إن محدودية الدالة COUNTIF تكمن في طبيعتها البنيوية: فهي مصممة لإرجاع عدد الخلايا ضمن نطاق معين التي تطابق معياراً ما، وليس عدد مرات تكرار الرمز داخل الخلية الواحدة. فإذا احتوت خلية على السلسلة “banana” واستُخدمت الدالة مع رمز النجمة كمعيار مطابقة جزئية، فإن الدالة ستُرجع القيمة (1) مشيرة إلى أن الخلية تحتوي على الحرف المطلوب، متجاهلة تماماً حقيقة أن الحرف “a” يتكرر ثلاث مرات داخل هذه السلسلة المفردة. هذا القصور الوظيفي يستدعي بناء صيغ حسابية مركبة قادرة على سبر أغوار السلسلة النصية ذاتها.
2. الأساس المنطقي والرياضي للصيغ الحسابية: تفكيك دالتي LEN وSUBSTITUTE
2.1 الدالة LEN: قياس الأطوال النصية الكلية
تُمثل الدالة LEN الأداة القياسية الأساسية في جداول بيانات جوجل لقياس الحجم الكلي لأي سلسلة نصية. رياضياً، تُعرف هذه الدالة كاقتران قياسي يأخذ وسيطاً نصياً واحداً ويُرجع عدداً صحيحاً موجباً يمثل إجمالي عدد المحارف المكونة لتلك السلسلة. لا تفرق الدالة LEN في احتسابها بين الحروف الأبجدية، أو الأرقام، أو الرموز الخاصة، أو حتى المسافات البيضاء الفاصلة والبادئة واللاحقة؛ فكل مدخل رمزي يُعامل كوحدة بنائية واحدة مستقلة تُضاف إلى المجموع التراكمي لطول النص في الخلية المستهدفة.
تعتمد آلية الإرجاع العددي في دالة LEN على استنطاق مصفوفة البايتات المكونة للمحارف المخزنة في ذاكرة البرنامج. فعند تمرير الخلية A2 إلى الدالة بصيغة =LEN(A2)، تقوم الخوارزمية الداخلية بحساب عدد الوحدات النصية المرجعية الممتدة من الحرف الأول وحتى الحرف الأخير. وتكتسب هذه القيمة المرجعية أهميتها من كونها تعكس الحالة الأصلية الخام للنص قبل إجراء أي عمليات تعديل أو اقتطاع.
في سياق النمذجة الرياضية لحساب تكرار الرموز، تُمثل القيمة العددية المرجعة بواسطة LEN النقطة المرجعية الأساسية (Baseline)؛ إذ يستحيل قياس الفروق الحجمية الناتجة عن إزالة أحرف معينة دون معرفة الحجم الأولي بدقة متناهية. إن أي خطأ في تقدير هذا الطول الأولي — نتيجة وجود مسافات خفية أو محارف تحكم غير مرئية — سينعكس مباشرة وبشكل تضاعفي على دقة المؤشرات الإحصائية المشتقة لاحقاً.
2.2 الدالة SUBSTITUTE: الاستبدال الانتقائي للمحارف
تؤدي الدالة SUBSTITUTE وظيفة جراحية دقيقة في بنية السلاسل النصية؛ إذ صُممت لاستبدال نص قديم بنص جديد داخل سلسلة محددة، دون المساس بالنص الأصلي المخزن في الذاكرة الدائمة ما لم يُطلب ذلك صراحة. وتتكون البنية التركيبية القياسية لهذه الدالة من ثلاثة متغيرات إلزامية ورابع اختياري: النص الأصلي الخاضع للمعالجة، والنص القديم المستهدف بالاستبدال، والنص البديل المراد إحلاله، بالإضافة إلى وسيط اختياري يحدد رقم التكرار المراد استبداله إذا لم تكن هناك رغبة في استبدال كافة التكرارات.
في سياق استراتيجية احتساب الأحرف، يتم توظيف الدالة SUBSTITUTE بأسلوب استبعادي؛ حيث يُحدد النص البديل كسلسلة نصية فارغة تماماً يُعبر عنها بزوج من علامات التنصيص المزدوجة المتلاصقة (“”). وبناءً على ذلك، تقوم الخوارزمية بمسح السلسلة النصية الأصلية من بدايتها إلى نهايتها، وعندما تعثر على أي تطابق تام مع المحرف المستهدف، فإنها تقوم بحذفه نهائياً وتضييق السلسلة حول موضعه، مما ينتج عنه نص جديد مشتق يقل طوله الإجمالي بمقدار يعادل الحجم التراكمي للمحارف التي تم استبعادها.
من الأهمية بمكان التأكيد على أن دالة SUBSTITUTE تتميز بطبيعة معالجة صارمة وحساسة لحالة الأحرف افتراضياً. فهذه الدالة تقارن الرموز وفقاً لقيمها الرقمية الدقيقة في جدول المحارف؛ وعليه، فإن تمرير الحرف اللاتيني الصغير “x” كهدف للاستبدال سيجعل الخوارزمية تتجاهل تماماً وجود الحرف اللاتيني الكبير “X”. هذا السلوك الصارم يمثل سلاحاً ذا حدين: فهو يوفر من جهة دقة فائقة عندما يكون التمييز بين الحالات مطلوباً، لكنه يتطلب من جهة أخرى تدخلاً برمجياً إضافياً عند الرغبة في إجراء حصر شامل ومحايد لحالة الأحرف.
2.3 المبدأ الحسابي للطرح التفاضلي بين الطولين
يقوم المبدأ الحسابي لاحتساب تكرار محرف معين على نموذج رياضي غاية في الأناقة والبساطة يُعرف بنموذج “الطرح التفاضلي للأطوال النصية” (Length-Difference Method). يفترض هذا النموذج أن لدينا سلسلة نصية أصلية ذات طول محدد يُرمز له بالرمز L1، وأنه بعد إزالة كافة تكرارات محرف معين، نحصل على سلسلة نصية منقوصة ذات طول أصغر يُرمز له بالرمز L2. وبما أن كل عملية حذف لمحرف فردي تُنقص طول السلسلة بمقدار وحدة واحدة فقط، فإن الفرق المطلق بين الطولين يعادل بالضرورة العدد الكلي للتكرارات المحذوفة.
رياضياً، يمكن التعبير عن هذا الإثبات بالصيغة الآتية: إذا كانت السلسلة النصية S تتكون من مجموعة محارف C، وكان المحرف المستهدف بالعد هو c، فإن عدد تكرارات المحرف n(c) يرتبط بالأطوال بالعلاقة المباشرة:
n(c) = Length(S) – Length(S – {c})
حيث يمثل المقدار الثاني طول السلسلة الناتجة بعد حذف كافة عناصر c بواسطة دالة الاستبدال بالسلسلة الفارغة. وبما أن طول السلسلة الفارغة يساوي صفراً، فإن المقدار المحذوف من الطول الكلي يتناسب طردياً وبمعامل ضرب مقداره (1) مع عدد مرات ظهور المحرف المستهدف.
تتفوق هذه المقاربة التحليلية الرياضية تفوقاً ساحقاً على الخوارزميات اليدوية المعقدة التي تعتمد على التفكيك المتتابع للمصفوفات عبر حلقات برمجية مخصصة؛ إذ تستفيد هذه الصيغة من التحسينات البرمجية المنفذة بلغة C++ والمبنية في النواة المركزية لجداول بيانات جوجل، مما يجعل تنفيذها فائق السرعة، ولا يستهلك سوى قدر ضئيل جداً من ذاكرة المتصفح وموارد المعالجة السحابية مقارنة بالحلول البرمجية النصية الأخرى.
3. حساب الأحرف مع مراعاة حالة الأحرف (Case-Sensitive Formula)
3.1 البنية التركيبية للصيغة القياسية الحساسة للحالة
تُعد الصيغة القياسية الحساسة لحالة الأحرف التطبيق المباشر والأكثر نقاءً لنموذج الطرح التفاضلي. تأخذ هذه الصيغة بنية محددة يتم إدخالها في شريط المعادلات وفق النمط الآتي: =LEN(A2)-LEN(SUBSTITUTE(A2,”a”,””)). في هذا التركيب، تشير الخلية A2 إلى موقع النص المراد تحليله، بينما يمثل الرمز “a” المحرف الدقيق المستهدف بالعد والإحصاء. تقوم الخلية الحسابية أولاً باستدعاء الطول الكلي عبر الجزء الأيسر من المعادلة، ثم تطرح منه الطول المشتق الناتج عن الجزء الأيمن بعد استبعاد الحرف “a” حصراً.
تتجلى الحساسية لحالة الأحرف في هذه الصيغة من خلال سلوك دالة SUBSTITUTE؛ فإذا احتوت الخلية A2 على كلمة مثل “Apple”، فإن الدالة ستبحث عن الحرف الصغير “a”. ونظراً لأن الكلمة تبدأ بحرف كبير “A”، فإن خوارزمية الاستبدال لن تجد أي تطابق للحرف الصغير “a” في بداية الكلمة، مما يجعل السلسلة الناتجة مطابقة تماماً للأصل بطول خمسة محارف، ويكون ناتج الطرح الرياضي هو 5 – 5 = 0. في المقابل، إذا كان الحرف المستهدف هو الحرف الكبير “A”، فإن الصيغة ستُرجع القيمة 1 بدقة متناهية.
يتميز هذا السلوك الخوارزمي في جداول بيانات جوجل بالصرامة الرياضية والانضباط المعياري؛ فهو يمنع التداخل غير المقصود بين الرموز التي تشترك في الرسم الشكلي وتختلف في التعيين الشفري. وتعمل هذه الصيغة بكفاءة استثنائية مع كافة الأبجديات التي تعتمد التمييز بين الحروف الكبيرة والصغيرة، كاللاتينية والسيريلية واليونانية، موفرة بذلك أداة قياس ميكروسكوبية للمحتوى النصي.
3.2 حالات الاستخدام الأكاديمي والتحليلي للمعادلة الحساسة
تتعدد التطبيقات البحثية والأكاديمية التي تتطلب استخدام المعادلة الحساسة لحالة الأحرف بشكل إلزامي؛ ففي مجالات المعلوماتية الحيوية والكيمياء الحاسوبية، تُكتب الصيغ الكيميائية والرموز الجزيئية بتسلسلات تعتمد اعتماداً حاسماً على حالة الحرف للتمييز بين العناصر. فعلى سبيل المثال، يمثل الرمز “Co” عنصر الكوبالت، بينما يمثل الرمز “CO” مركب أول أكسيد الكربون المكون من الكربون والأكسجين. إن استخدام صيغة غير حساسة لحالة الأحرف في مثل هذه السياقات سيؤدي إلى كوارث تحليلية وتصنيفية تدمر موثوقية قواعد البيانات المخبرية.
كذلك تبرز أهمية هذه المعادلة في مجال علوم الحاسوب وتحليل الشيفرات البرمجية (Source Code Analysis) وفحص السجلات التقنية المكتوبة بلغات برمجة حساسة لحالة الأحرف مثل Python أو Java أو C++. ففي هذه البيئات، تختلف المتغيرات والمعرفات باختلاف حالة الحرف، ويتطلب تدقيق الجودة البرمجية احتساب تكرار أنماط محددة من الرموز الكبيرة والصغيرة لتقييم مدى الالتزام بمعايير التسمية الاصطلاحية (مثل معيار camelCase أو PascalCase).
وفي دراسات التصنيف المعياري ومراجعة الوثائق القانونية والمالية، تُستخدم الصيغ الحساسة للحالة للتأكد من مطابقة المعرفات الأكاديمية ورموز التوثيق الموحدة (مثل معرفات الكائنات الرقمية DOIs)، والتحقق من صحة مفاتيح التشفير والرموز الأمنية التي تعتمد على التباديل الدقيقة بين الأحرف اللاتينية الكبيرة والصغيرة لضمان تعقيد السلسلة النصية ومقاومتها للاختراق.
4. حساب الأحرف دون مراعاة حالة الأحرف (Case-Insensitive Formula)
4.1 دمج دالة التحويل LOWER لتجاوز قيود الحالة
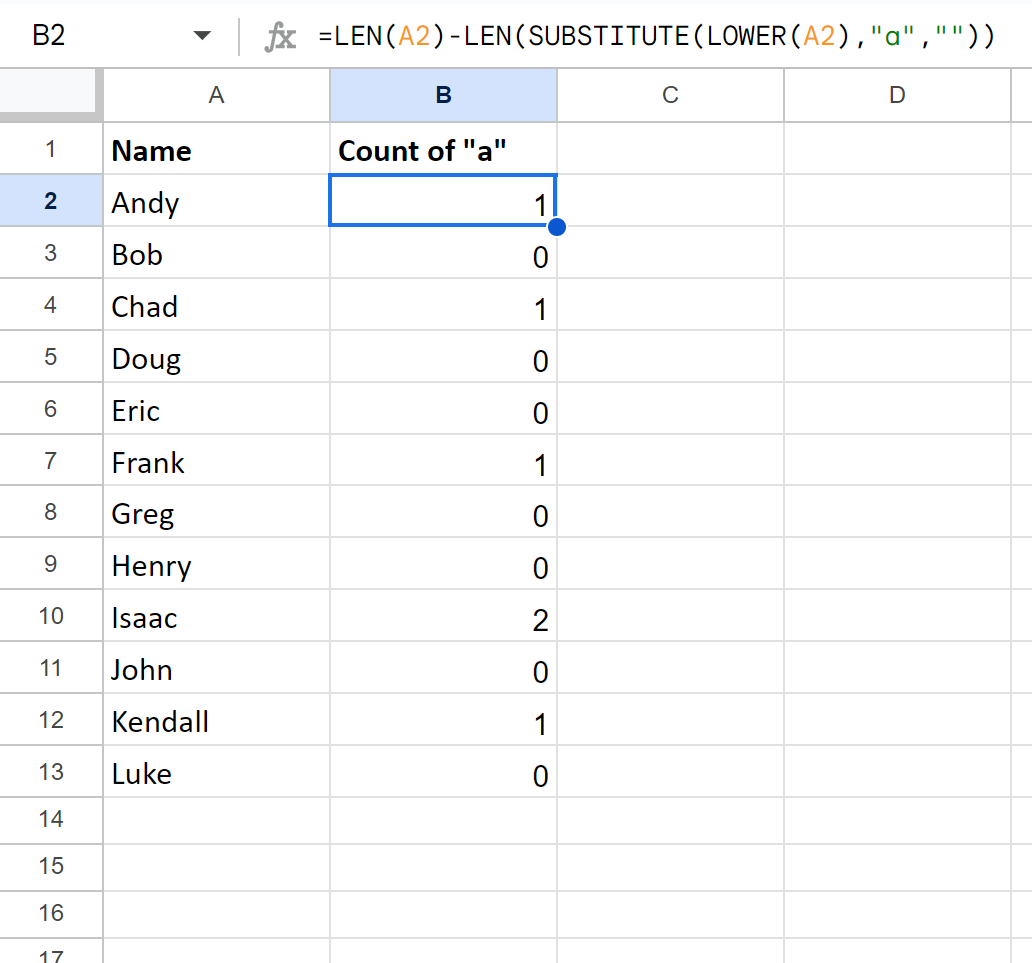
عندما تقتضي متطلبات التحليل الإحصائي التركيز على تكرار المحرف المجرد بصرف النظر عن صيغته الشكلية (سواء كان كبيراً أم صغيراً)، تصبح الصيغة الحساسة عاجزة عن توفير الرقم الإجمالي الدقيق. لتجاوز هذه العقبة الهيكلية، يتم إدماج دالة تحويل حالة الأحرف LOWER ضمن البنية التفاضلية، لتصبح الصيغة المتقدمة كالآتي: =LEN(A2)-LEN(SUBSTITUTE(LOWER(A2),”a”,””)). يمثل هذا التعديل نقلة نوعية في مرونة المعالجة النصية داخل جداول البيانات.
تتمثل الوظيفة الجوهرية لدالة LOWER في تحويل كافة المحارف اللاتينية الكبيرة الموجودة في الخلية A2 إلى نظائرها الصغيرة بصورة مؤقتة داخل وسيط دالة الاستبدال، دون إحداث أي تغيير دائم في النص الأصلي المعروض في الخلية. ونتيجة لهذا التحويل الشامل، تصبح السلسلة النصية الخاضعة للاستبدال موحدة النمط، وعندما تُوجه دالة SUBSTITUTE لحذف الحرف الصغير “a”، فإنها تتمكن من رصد واستئصال كافة الحالات التي كانت في أصلها كبيرة “A” وتلك التي كانت صغيرة “a” على حد سواء.
يوفر هذا النموذج الرياضي ضمانة إحصائية كاملة لاحتساب التكرار الشامل للمحرف المستهدف عبر السلسلة النصية؛ حيث يتم تجريد النص من التمايزات الشكلية للرموز قبل تطبيق خوارزمية الحذف التفاضلي، مما يمنع حدوث أي نقص أو تشويه في بيانات العد الإحصائي المجمعة للمتغيرات النصية المدروسة.
4.2 البديل المكافئ باستخدام دالة التحويل UPPER
من المنظور الرياضي والبرمجي البحت، يتوفر بديل مكافئ تماماً للصيغة السابقة يعتمد على دالة التحويل العكسية UPPER، والتي تصاغ بالشكل الآتي: =LEN(A2)-LEN(SUBSTITUTE(UPPER(A2),”A”,””)). في هذه الصيغة، يتم رفع كافة محارف الخلية A2 إلى حالتها الكبيرة، مع توجيه دالة الاستبدال لحذف الحرف المستهدف بصيغته الكبيرة “A”. يحقق هذا النموذج النتيجة الحسابية ذاتها بدقة تبلغ مئة بالمئة مقارنة بنموذج LOWER.
عند إجراء مقارنة أداء دقيقة بين استخدام LOWER واستخدام UPPER من حيث سرعة المعالجة واستهلاك الذاكرة في جداول بيانات جوجل، تُظهر النتائج تطابقاً شبه تام في الكفاءة الحاسوبية؛ إذ ينتمي كلا التابعين إلى الفئة ذاتها من دوال التحويل الخطي للمصفوفات المحرفية في محرك V8 المشغل للمنصة السحابية. وبناءً على ذلك، لا توجد أي أفضلية خوارزمية ترجح كفة إحدى الدالتين على الأخرى من حيث سرعة التنفيذ.
تستند معايير الاختيار بين الدالتين في المقام الأول إلى التفضيلات التوثيقية والاتساق المنهجي المعتمد داخل المشروع البحثي؛ فإذا كانت قاعدة البيانات تتضمن معرفات تُكتب تقليدياً بأحرف كبيرة (مثل رموز المطارات المعيارية IATA أو رموز العملات الدولية)، فقد يفضل المحلل استخدام UPPER للحفاظ على النمط الذهني الموحد لقواعد التسمية، بينما يُفضل استخدام LOWER في الأبحاث اللغوية والأدبية العامة لتطابقها مع المعالجة القياسية للمتون المعجمية.
5. التطبيق العملي ونمذجة الحالات على مجموعات البيانات
5.1 تطبيق الصيغة الحساسة للحالة على قائمة أسماء تجريبية
لتوضيح الفروق الجوهرية بين النماذج الحسابية في بيئة تطبيقية واقعية، نفترض وجود قائمة تجريبية لأسماء المشاركين في دراسة مسحية مدرجة في العمود A من ورقة البيانات، تبدأ من الخلية A2 وحتى A6، وتضم الأسماء الآتية بالتتابع: “Andy”، “Amanda”، “Aaron”، “Sara”، و”BARBARA”. يُطلب من فريق التحليل استخراج تكرار الحرف اللاتيني الصغير “a” حصراً في عمود مساعد (العمود B) باستخدام الصيغة القياسية الحساسة للحالة: =LEN(A2)-LEN(SUBSTITUTE(A2,”a”,””)).
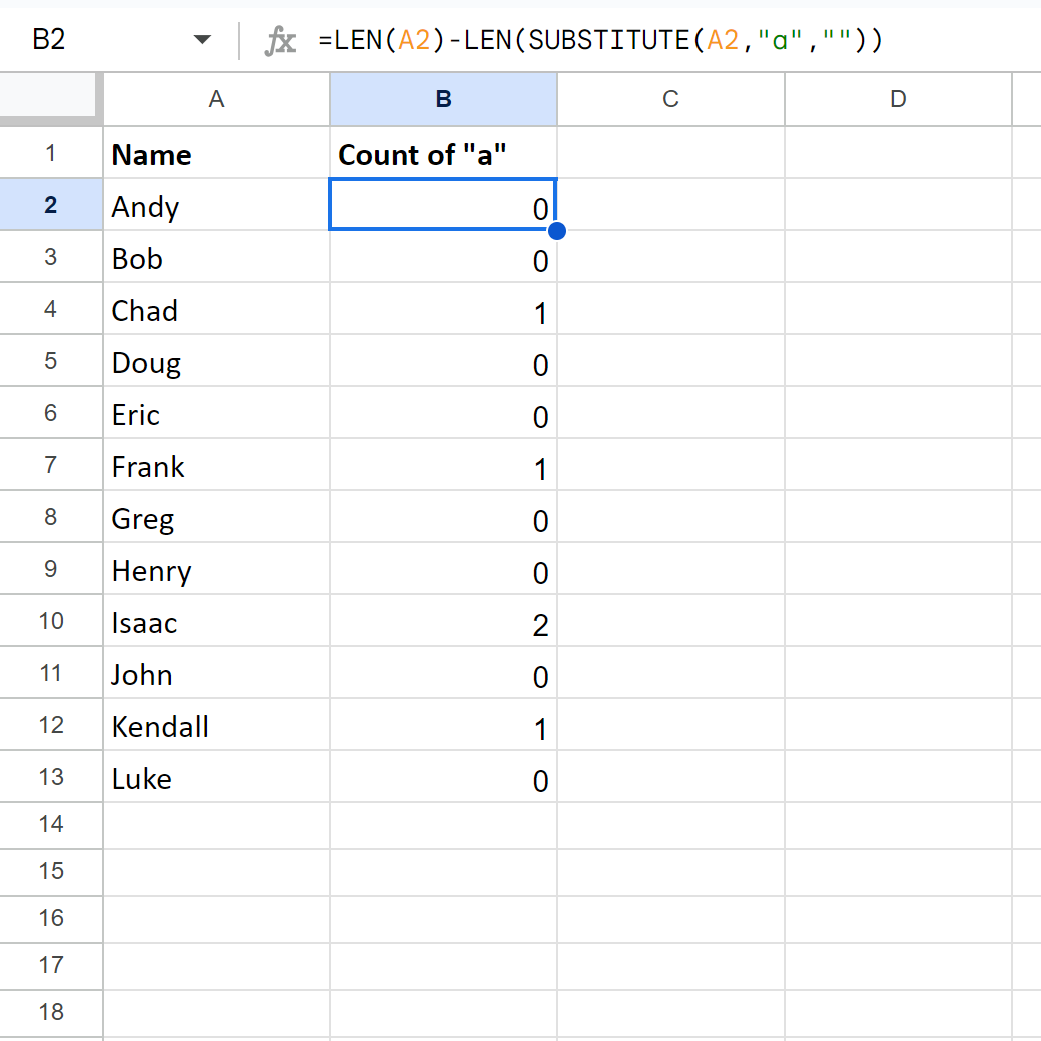
عند تطبيق المعادلة وسحبها رأسياً على طول النطاق، نلاحظ سلوكاً إحصائياً يستحق التحليل المتعمق. ففي السجل الأول الذي يحتوي على الاسم “Andy”، تُرجع الخلية B2 القيمة (0)؛ ويعود هذا التفسير الرياضي إلى أن الحرف “A” في بداية الاسم ورد كحرف كبير، ولم تتضمن بقية بنية الاسم أي أحرف صغيرة مطابقة، مما جعل دالة الاستبدال تعجز عن رصد الحرف “a”، فبقي طول الاسم أربعة محارف قبل وبعد الاستبدال (4 – 4 = 0). أما في السجل الثاني “Amanda”، فإن المعادلة تُرجع القيمة (2)، حيث تجاهلت الحرف الأول الكبير ورصدت الحرفين الثاني والثالث الصغيرين.
تظهر القراءات تبايناً حاداً عند الانتقال إلى السجل الأخير “BARBARA”، حيث تُرجع المعادلة الحساسة القيمة (0) بشكل كامل على الرغم من تكرار حرف الألف اللاتيني ثلاث مرات داخل الاسم؛ والسبب هو كتابة الاسم بأكمله بأحرف كبيرة، مما يُثبت بما لا يدع مجالاً للشك أن الصيغة الحساسة للحالة تقوم بعملية عزل وفرز صارمة تقتصر على الهيئة المطابقة للمدخلات دون أي تأويل خوارزمي مستقل.
5.2 تطبيق الصيغة غير الحساسة للحالة على البيانات ذاتها
في المرحلة التالية من النمذجة، نُدرج المعادلة غير الحساسة للحالة في العمود C المقابل للبيانات ذاتها عبر تطبيق صيغة التوحيد باستخدام دالة LOWER: =LEN(A2)-LEN(SUBSTITUTE(LOWER(A2),”a”,””))، ثم نقوم بتعميم المعادلة على كافة الصفوف المقابلة لرصد الفروق الإحصائية المترتبة على تحييد متغير حالة الحرف.
تسفر النتائج المحدثة في العمود C عن تحولات جذرية في قراءات التكرار؛ ففي السجل الأول “Andy”، ارتفعت النتيجة من (0) إلى (1)، حيث قامت الدالة LOWER بتحويل السلسلة إلى “andy”، مما مكن دالة الاستبدال من رصد الحرف واقتطاعه بنجاح. وفي السجل الثاني “Amanda”، قفزت القيمة من (2) إلى (3)، محققة الحصر الشامل لكافة تجليات الحرف داخل السلسلة. أما في السجل “BARBARA”، فقد حققت المعادلة قفزة إحصائية دراماتيكية من (0) إلى (3)، مسجلة الوجود الفعلي لكافة الأحرف بصرف النظر عن تنسيق الإدخال.
يعد توثيق هذه الفروق الإحصائية بين العمودين B وC إجراءً منهجياً بالغ الأهمية؛ فهو يُظهر بوضوح كيف يمكن أن يؤدي اختيار دالة غير مناسبة إلى حدوث خطأ منهجي من النوع الثاني (Type II Error) في التحليلات النصية، حيث يتم إسقاط تكرارات حقيقية للمتغير المدروس نتيجة قيد تقني شكلي، وهو ما يجب تجنبه في البحوث الأكاديمية الصارمة عبر التحديد المسبق للمستوى التحليلي المستهدف.
6. تقنيات توسيع النطاق: حساب تكرار الأحرف عبر نطاقات وخلايا متعددة
6.1 الدمج مع دالة المصفوفات ARRAYFORMULA للمعالجة التلقائية
في المشاريع البحثية الضخمة التي تتعامل مع مئات الآلاف من السجلات النصية، يصبح سحب المعادلات يدوياً عبر الخلايا ممارسة غير عملية وتزيد من احتمالية حدوث أخطاء بشرية وتفاوت في اتساق الصيغ، فضلاً عن استنزافها لذاكرة المتصفح. لحل هذه المعضلة الهيكلية، توفر جداول بيانات جوجل دالة المصفوفات الشاملة ARRAYFORMULA، والتي تتيح تطبيق خوارزمية العد التفاضلي على نطاق كامل بدفعة معالجة واحدة وبصيغة مركزية تُكتب في الخلية الرأسية الأولى فقط: =ARRAYFORMULA(LEN(A2:A)-LEN(SUBSTITUTE(LOWER(A2:A),”a”,””))).
تتمثل الآلية الوظيفية لهذه الصيغة المصفوفية في اعتراض متجهات النطاق المدخلة A2:A وتحويلها إلى تدفق مستمر من البيانات النصية يمر عبر المعالجة التفاضلية؛ حيث تقوم الدالة بحساب الفروق الحجمية لكل صف على حدة بصورة متزامنة داخل محرك المعالجة، وتقوم بتوزيع النتائج تلقائياً على الخلايا المقابلة دون الحاجة لتكرار إدخال الصيغة في كل خلية على حدة.
يؤدي هذا الأسلوب إلى تحسين جذري في كفاءة استهلاك موارد المعالج؛ إذ تُعامل ورقة العمل هذه الصيغة ككيان منطقي واحد (Single Logical Entity) ضمن شجرة التبعيات الحسابية (Dependency Tree)، مما يقلل بشكل ملموس من زمن إعادة الحساب (Recalculation Time) عند تحديث البيانات ويوفر استقراراً تقنياً عالياً لقواعد البيانات البحثية التشاركية عبر السحابة.
6.2 التجميع الإحصائي الكلي للمحارف عبر دالة SUM أو SUMPRODUCT
في العديد من التصاميم البحثية، لا تقتضي أهداف الدراسة معرفة تكرار الحرف في كل سجل منفصل، بل يتطلب التحليل استخراج المؤشر الإجمالي الكلي لتكرار محرف معين عبر كامل الوثيقة أو قاعدة البيانات لاستخدامه في معادلات الكثافة المعجمية أو تقدير حجم العينة النصية الإجمالية. لتحقيق هذه الغاية دون إنشاء أعمدة مساعدة تستهلك مساحة التخزين البصرية، يتم دمج خوارزمية الطرح التفاضلي داخل دالة التجميع الإحصائي SUMPRODUCT أو الدالة المركبة SUM مع ARRAYFORMULA.
تأخذ الصيغة المدمجة باستخدام دالة SUMPRODUCT البنية الرياضية الآتية: =SUMPRODUCT(LEN(A2:A10)-LEN(SUBSTITUTE(A2:A10,”x”,””))). وتكمن الميزة الاستثنائية لدالة SUMPRODUCT في قدرتها الذاتية على معالجة النطاقات المصفوفية دون الحاجة للتصريح الصريح عن ARRAYFORMULA؛ إذ تقوم باحتساب مصفوفة الفروق التفاضلية للخلايا من A2 إلى A10 في الذاكرة اللحظية، ثم تجمع نواتج تلك المصفوفة لتُرجع قيمة قياسية واحدة تمثل المجموع التراكمي الدقيق لظهور الحرف المستهدف في كامل النطاق.
كما يمكن تحقيق النتيجة ذاتها باستخدام التركيب المكافئ: =SUM(ARRAYFORMULA(LEN(A2:A10)-LEN(SUBSTITUTE(A2:A10,”x”,””)))). تبرز التطبيقات المنهجية لهذه الصيغ التجميعية في قياس الكثافة الحرفية (Character Density)، ومراقبة مدى اتساع المفردات في المتون النصية الكبرى، فضلاً عن إجراء المقارنات الإحصائية بين نصوص مؤلفين متباينين ضمن دراسات قياس الأسلوب الإحصائي (Stylometry).
7. التعامل مع الرموز الخاصة، الفواصل، والمسافات البيضاء في النصوص
7.1 حساب المسافات البيضاء وعلامات الترقيم
لا يقتصر تطبيق نموذج الطرح التفاضلي على الحروف الأبجدية، بل يمتد بكفاءة عالية ليشمل حساب تكرار المسافات البيضاء وعلامات الترقيم والرموز غير المطبوعة، وهو إجراء محوري في أبحاث تحليل المحتوى واستكشاف النصوص. فعلى سبيل المثال، يمثل احتساب عدد المسافات الفاصلة داخل جملة معينة المدخل الأكثر شيوعاً لتقدير عدد الكلمات الإجمالي رياضياً؛ حيث يُفترض وفق القواعد المعجمية أن عدد الكلمات في الجملة السليمة يساوي عدد المسافات البيضاء الفاصلة مضافاً إليه واحد، وتُكتب صيغتها كالآتي: =LEN(A2)-LEN(SUBSTITUTE(A2,” “,””))+1.
وعند التعامل مع الرموز الخاصة مثل علامات التنصيص أو الفواصل المزدوجة، تفرض جداول بيانات جوجل قواعد برمجية محددة لمنع تضارب الصيغ؛ فإذا أردنا احتساب تكرار علامة التنصيص المزدوجة (“) ذاتها، يتوجب الهروب البرمجي (Escaping) عبر تكرار الرمز داخل الوسيط، لتصاغ الدالة بالشكل الآتي: =LEN(A2)-LEN(SUBSTITUTE(A2,””””,””))، حيث تمثل علامات التنصيص الأربع الداخلية تمثيلاً لرمز تنصيص مفرد محاط بحدود الوسيط النصي للدالة.
تكتسب هذه التقنية أهمية منهجية قصوى عند استيراد وتنظيف الملفات النصية المجدولة المنفصلة بفواصل (CSV)؛ إذ يُعد التحقق من تطابق عدد الفواصل في كل سطر مع العدد المعياري للأعمدة الوسيلة الأسرع لرصد وتصحيح التلف البنيوي في السجلات الناتجة عن أخطاء إدخال النصوص أو وجود فواصل غير معالجة داخل الحقول الوصفية، وهو ما يتسق مع الممارسات المنهجية المتبعة في تنظيف البيانات الرقمية المستخرجة من المنصات الإلكترونية (Robinson et al., 2018; Zhang et al., 2021).
7.2 حساب الأحرف المزدوجة والمقاطع النصية متعددة الرموز
تتعقد المعادلة الحسابية عندما لا يكون الهدف محصوراً في محرف فردي، بل يمتد ليشمل حساب تكرار مقطع نصي مركب (Substring) أو كلمة معينة تتكون من حرفين أو أكثر (مثل حساب تكرار كلمة “the” أو المقطع “ing” داخل خلية). في هذه الحالة، يتوقف افتراض أن الحذف يؤدي إلى إنقاص الطول بمقدار وحدة واحدة؛ فكل عملية استبدال لمقطع مكون من ثلاثة محارف ستؤدي بالضرورة إلى انكماش طول السلسلة النصية بمقدار ثلاثة محارف دفعة واحدة.
ولمعالجة هذا التغير البنيوي وضمان الدقة الرياضية، يجب تعديل النموذج التفاضلي بقسمة ناتج الطرح الإجمالي على الطول الحقيقي للمقطع النصي المستهدف بالعد. وتصاغ المعادلة الرياضية المعيارية لحساب السلاسل المتعددة على النحو الآتي: =(LEN(A2)-LEN(SUBSTITUTE(A2,”sub”,””)))/LEN(“sub”). في هذا التركيب، يقيس البسط الفارق الكلي في عدد المحارف المفقودة، بينما يعمل المقام على ضبط القياس وفقاً لمقياس الرسم الحجمي للمقطع المستهدف.
الإثبات الرياضي لهذه الصيغة يرتكز على حقيقة أن استبدال مقطع ذي طول k يتكرر m من المرات بسلسلة فارغة سينتج عنه نقص إجمالي في الطول مقداره m مضروباً في k. وعليه، فإن قسمة المقدار الكلي المحذوف (m * k) على طول المقطع (k) يُرجع بالضرورة القيمة الصحيحة m التي تعبر عن التكرار الفعلي للكلمة أو المقطع، مما يوفر أداة رياضية صارمة وموضوعية لتحليل التكرارات البنائية المعقدة في النصوص.
8. الأخطاء الشائعة واستراتيجيات التحقق وتصحيح الصيغ
8.1 معالجة الخلايا الفارغة والقيم غير النصية
تواجه الصيغ التفاضلية بيئات بيانات غير مثالية في التطبيقات الواقعية؛ حيث تتكرر مواجهة خلايا فارغة أو خلايا تحتوي على قيم رقمية محضة أو تواريخ، مما قد يؤدي إلى سلوكيات حسابية غير متوقعة أو ظهور قيم صفرية تشوه الحسابات اللاحقة. فعندما تُطبق المعادلة على خلية فارغة تماماً، تُرجع دالة LEN القيمة (0)، وتُرجع دالة الاستبدال سلسلة فارغة بطول (0)، ليكون الناتج النهائي (0). ومع أن النتيجة رياضياً سليمة، إلا أنها قد تُفسر خطأً في الدراسات الإحصائية على أنها إشارة إلى وجود نص خلو من الحرف، بدلاً من تصنيفها كقيمة مفقودة (Missing Value).
لتفادي هذا الخلط المنهجي ولحماية مصفوفة النتائج، يُوصى بتطويق الصيغة بدوال التحقق الشرطي، وتحديداً دالتي IF وISBLANK، لتصاغ المعادلة المحمية بالشكل الآتي: =IF(ISBLANK(A2),””,LEN(A2)-LEN(SUBSTITUTE(A2,”a”,””))). وبموجب هذا التركيب، يتم فحص الخلية أولاً؛ فإذا كانت خالية، تُرجع المعادلة قيمة فارغة تحافظ على التوزيع الأصلي للبيانات المفقودة، وتمنع انحياز مقاييس النزعة المركزية عند احتساب متوسط تكرار الحروف.
أما في الحالات التي تحتوي فيها الخلايا على قيم رقمية صلبة يرغب المحلل في معاملتها كنصوص لحساب تكرار رقم معين (مثل حساب تكرار الرقم 5 في المعرفات الرقمية)، فيجب تطبيق التحويل القسري لنوع البيانات عبر دالة TO_TEXT لتفادي حدوث أخطاء عدم تطابق الأنواع في محرك الجداول، وتُكتب الصيغة حينئذ: =LEN(TO_TEXT(A2))-LEN(SUBSTITUTE(TO_TEXT(A2),”5″,””))، مما يضمن تدفقاً سلساً وخالياً من التعثر الحسابي عبر كافة أنواع البيانات المدخلة.
8.2 أخطاء علامات التنصيص والمحارف المخفية
تُمثل أخطاء التنسيق المتعلقة بعلامات التنصيص والمحارف غير المرئية أحد أكثر مصادر الخطأ خفاءً وتأثيراً على دقة الحساب النصي. فمن الأخطاء المتكررة استخدام علامات التنصيص المائلة أو الذكية (Smart Quotes: “ ”) التي تولدها معالجات النصوص المتقدمة بدلاً من علامات التنصيص البرمجية المستقيمة (” “). يؤدي هذا الاستبدال الشكلي غير الواعي إلى عجز محرك جداول بيانات جوجل عن تفسير وسائط الدالة، مما يُسفر عن ظهور خطأ الصياغة الشهير (#ERROR!).
علاوة على ذلك، تشكل المسافات البيضاء الزائدة — سواء كانت بادئة في صدر النص، أو لاحقة في عجزه، أو مسافات متتالية متعددة تفصل بين الكلمات — تشويهاً غير مرئي للمقاييس الحجمية؛ إذ ترفع تلك المسافات من القيمة المرجعية للطول الكلي المقاس عبر LEN دون أن تعبر عن محتوى نصي حقيقي. وتزداد هذه المشكلة تفاقماً عند استيراد نصوص تتضمن محارف تحكم غير مطبوعة (Non-Printable Characters) مثل نهايات الأسطر (Line Breaks) أو علامات الجدولة (Tabs).
ولضمان سلامة ونزاهة التحليل الإحصائي، تقتضي الممارسة المنهجية الرصينة إخضاع السلاسل النصية لعملية تطهير قبلي عبر دمج دالتي TRIM وCLEAN ضمن الصيغة الحسابية أو في عمود تنقية مسبق. تعمل دالة TRIM على حذف المسافات الزائدة وحصر المسافات بين الكلمات في مسافة مفردة فقط، بينما تقوم دالة CLEAN باكتساح محارف التحكم غير المرئية وفق شفرات ASCII الأولى، مما يهيئ النص الخام ويحوله إلى مادة قياسية نقية تخضع للعد التفاضلي بيقين إحصائي تام.
9. بدائل برمجية متقدمة: استخدام دوال التعبيرات النمطية (REGEX)
9.1 توظيف REGEXREPLACE كبديل أكثر مرونة وديناميكية
تمثل دوال التعبيرات النمطية المدمجة في جداول بيانات جوجل قمة المرونة والعمق البرمجي في معالجة النصوص. ومن بين هذه الأدوات، تبرز دالة الاستبدال النمطي REGEXREPLACE كبديل متفوق وخارق للحدود مقارنة بالدالة التقليدية SUBSTITUTE؛ حيث تتيح البحث باستخدام قواعد ومحددات نمطية مجردة بدلاً من التطابق الحرفي البسيط. يمكن بناء صيغة احتساب أحرف متطورة تعتمد على المنطق العكسي عبر استبعاد كافة المحارف التي *لا تطابق* الحرف المستهدف، وتصاغ بالشكل الآتي: =LEN(REGEXREPLACE(A2,”[^x]”,””)).
تعتمد هذه الصيغة على فئة المحارف المنفية المحددة بالرمز [^x]، والتي تعني برمجياً: “ابحث عن أي محرف داخل السلسلة باستثناء المحرف x، واستبدله بسلسلة فارغة”. ونتيجة لهذا المنطق المقلوب، يتم محو كافة محتويات الخلية باستثناء تكرارات الحرف المستهدف “x”، لتبقى سلسلة نقية تتألف حصراً من تكرارات ذلك الحرف، ويكون قياس طولها عبر الدالة الخارجية LEN معادلاً بصورة مباشرة وتلقائية لعدد مرات تكراره دون الحاجة لإجراء عملية طرح تفاضلي.
كما تتيح التعبيرات النمطية تجاوز قيود حساسية حالة الأحرف بمرونة فائقة من خلال إدماج معدل عدم الحساسية (?i) مباشرة في النمط النصي، كما في الصيغة: =LEN(REGEXREPLACE(A2,”(?i)[^x]”,””)). ومع ذلك، يجب على المحلل إدراك المقايضة التقنية المصاحبة؛ فمحركات التعبيرات النمطية تستهلك دورات معالجة إضافية وزمن تنفيذ أطول نسبياً مقارنة بدالة SUBSTITUTE الصريحة، مما يجعل استخدامها مفضلاً في التحليلات المعقدة التي تعجز عنها الدوال البسيطة، مع تجنبها في الجداول المليونية المزدحمة بالبيانات الروتينية.
9.2 حساب الأحرف باستخدام دوال REGEXEXTRACT ومصفوفات الاستخراج
يبرز بديل نمطي متقدم آخر يعتمد على استخراج المحارف المستهدفة إلى مصفوفة افتراضية منفصلة ثم حصر عناصرها عددياً عبر دالة العد العام COUNTA. ورغم أن دالة REGEXEXTRACT التقليدية تكتفي افتراضياً باستخراج التطابق الأول فقط، إلا أن إدماجها مع تقسيم السلسلة وتجزئتها عبر التعبيرات النمطية يمكّن من بناء خط معالجة بياني متميز قادر على التعامل مع فئات ومجموعات محرفية متكاملة بضربة واحدة.
تكتسب هذه الاستراتيجية المتقدمة بريقها التحليلي عند الرغبة في حساب تكرار فئات معقدة بدلاً من محرف وحيد؛ كحساب إجمالي الأرقام الواردة في نص هجين باستخدام النمط [0-9]، أو حصر الأحرف الصوتية اللاتينية (Vowels) باستخدام الفئة [aeiouAEIOU]، أو تتبع الرموز اللغوية الحساسة في دراسات الكشف الآلي عن الأنماط التعبيرية والمشاعر في النصوص الرقمية الكبرى (Safa et al., 2021; Aldhyani et al., 2022). إن توظيف الصيغة النمطية: =LEN(REGEXREPLACE(A2,”[^0-9]”,””)) يتيح فوراً معرفة عدد الخانات الرقمية دون كتابة صيغ استبدال متكررة لكل رقم على حدة.
وعلى الرغم من هذه القوة التعبيرية الهائلة، يجب توخي الحذر الشديد عند صياغة التعبيرات النمطية؛ فالأنماط غير المنضبطة قد تؤدي إلى إرجاع خطأ القيمة (#VALUE!) إذا لم يتواجد أي تطابق داخل النص المستهدف ما لم تُحط الصيغة بحارس الأخطاء IFERROR. لذا، يبقى التقييم الدقيق لحدود الأداة ومطابقتها للمتطلبات البحثية هو الفيصل المنهجي في اختيار مسار المعالجة الأنسب.
10. الممارسات الفضلى والاعتبارات المنهجية لإدارة وتنظيف البيانات النصية
10.1 توثيق الصيغ الرياضية وبناء نماذج قابلة لإعادة الاستخدام
يُعد التوثيق المنهجي للصيغ الحسابية معياراً لا غنى عنه لضمان قابلية إعادة الإنتاج والتحقق العلمي (Reproducibility) في المعالجات الإحصائية؛ إذ تميل المعادلات النصية المركبة إلى التعقيد البصري السريع، مما يجعل قراءتها وصيانتها مستقبلاً أمراً شاقاً. لتحقيق الشفافية البحثية، يتوجب على المحلل اعتماد تسميات معيارية واضحة وموحدة للأعمدة المشتقة، واستخدام خاصية “الملاحظات” (Notes) أو التعليقات لشرح المنطق الكامن خلف كل متغير ومعادلة، وتوثيق ما إذا كانت الصيغة المستخدمة حساسة لحالة الأحرف أم لا مع ذكر المبرر المنهجي لذلك.
وفي البيئات المؤسسية التي تتطلب تكرار هذه العمليات عبر مشاريع متعددة، يُنصح بتجاوز تعقيدات الصيغ الطويلة عبر برمجة دوال مخصصة (Custom Functions) باستخدام لغة البرمجة النصية لجداول بيانات جوجل (Google Apps Script). يمكن تطوير دالة بسيطة ونقية باسم COUNTCHAR(text, char, isCaseSensitive) تلخص العمليات السابقة في واجهة برمجية أنيقة تسهل استدعاء الخوارزمية وتمنع أخطاء النسخ واللصق اليدوي للمعادلات المتداخلة.
كما تقتضي قواعد إدارة البيانات الصارمة الفصل التام بين طبقة تنظيف البيانات الخام وطبقة التحليل الإحصائي المشتق؛ حيث يُحظر تطبيق معادلات العد مباشرة على النصوص الأصلية غير المنقحة. إن بناء ورقة عمل مخصصة لتهيئة النصوص وإزالة المحارف الشاذة، تليها ورقة مستقلة لاحتساب التكرارات واستخراج المؤشرات الكمية، يضمن الاحتفاظ بسجل تدقيق تاريخي (Audit Trail) متكامل يحمي البيانات من الفقد أو التشويه العرضي أثناء مراحل المعالجة المتعاقبة.
10.2 معايير الأداء عند معالجة المجموعات الضخمة من السجلات
عند التوسع في تحليل مجموعات البيانات الضخمة التي تضم عشرات أو مئات الآلاف من السجلات النصية، تصبح كفاءة الأداء الحوسبي قيداً تشغيلياً حاسماً؛ فالجداول السحابية تعتمد على بيئة تشغيل متصفح الويب المحدودة بالذاكرة المخصصة لجلسة المستخدم. إن الإفراط في استخدام الدوال المتقلبة أو بناء آلاف المعادلات الفردية المستقلة يؤدي إلى بطء شديد في التصفح واستنزاف لموارد المعالج وقد ينتهي بانهيار المتصفح تماماً.
لتحقيق أقصى كفاءة حوسبية ممكنة، يجب اتباع مبدأ “التجميد الحسابي” (Value Freezing) بمجرد استقرار واكتمال التحليلات؛ وذلك من خلال نسخ مصفوفة النتائج المحسوبة وإعادة لصقها كقيم نصية/عددية ثابتة (Paste as Values Only) فوق المعادلات التفاضلية. يؤدي هذا الإجراء العملي إلى قطع شجرة الاعتماد الحسابي وإعفاء محرك الجداول من إعادة حساب أطوال النصوص وفروق الاستبدال في كل مرة يتم فيها فتح ورقة العمل أو تعديل خلية مجاورة.
أخيراً، يؤكد فحص المنهجيات والبروتوكولات المعيارية في أبحاث إعادة الإنتاج والتكرار العلمي (Cova et al., 2018) على ضرورة إجراء تدقيق دوري مستقل على عينات عشوائية من المخرجات الحسابية لضمان مطابقة النتائج الرقمية المشتقة للفرضيات الموضوعية للبحث؛ فالتنفيذ البرمجي المتقن يظل عديم الجدوى ما لم يكن محكوماً بوعي نظري متكامل يربط بين الأداة الحاسوبية والهدف الإبستمولوجي للدراسة.
خاتمة
تناول هذا المقال الأكاديمي الموسع بالتشريح والتحليل الدقيق كافة الجوانب الرياضية والهيكلية والتطبيقية المرتبطة بمسألة كيفية حساب عدد أحرف معينة في جداول بيانات جوجل. وقد أثبت التحليل المنهجي أن غياب دالة قياسية مدمجة لا يمثل قصوراً وظيفياً في المنصة، بل يفتح المجال لبناء حلول خوارزمية بديعة تعتمد على الطرح التفاضلي للأطوال النصية عبر الجمع العبقري بين دالتي LEN وSUBSTITUTE. تتيح هذه المقاربة للمحلل والباحث سيطرة رياضية مطلقة تمكنه من ضبط حساسية حالة الأحرف، والتعامل مع المقاطع النصية المزدوجة، وتوسيع نطاق المعالجة نحو المصفوفات الكبرى والمجموعات التراكمية بكفاءة برمجية متميزة وسرعة معالجة فائقة.
إن إتقان هذه التقنيات، بدءاً من المعالجة التفاضلية البسيطة وصولاً إلى استخدام أحدث أنماط التعبيرات النمطية المتطورة، يمثل مهارة جوهرية لكل باحث ومحلل يسعى إلى تحويل البيانات النصية غير المهيكلة إلى مؤشرات كمية رصينة قابلة للتحليل الإحصائي والاختبار العلمي. ومع تزايد الاعتماد على جداول بيانات جوجل كأداة تشاركية مركزية في جمع وتنظيم وتدقيق البيانات في شتى حقول المعرفة المعاصرة، تظل المعرفة الدقيقة بتفاصيل محركاتها النصية والالتزام بممارسات التوثيق والتنظيف المعياري الضمانة الحقيقية لجودة المخرجات وصحة الاستدلال في عصر غزارة البيانات الرقمية.
المراجع
- Aldhyani, T. H. H., Alsubari, S. N., Alshebami, A. S., Alkahtani, H. S., & Ahmed, Z. A. T. (2022). Detecting and Analyzing Suicidal Ideation on Social Media Using Deep Learning and Machine Learning Models. International Journal of Environmental Research and Public Health. https://doi.org/10.3390/ijerph191912635
- Boulton, A., & Vyatkina, N. (2021). Thirty years of data-driven learning: Taking stock and charting new directions over time. Language learning & technology. https://doi.org/10.64152/10125/73450
- Cova, F., Strickland, B., Abatista, A., Allard, A., Andow, J., Attie, M., et al. (2018). Estimating the Reproducibility of Experimental Philosophy. Review of Philosophy and Psychology. https://doi.org/10.1007/s13164-018-0400-9
- Honary, M., Bell, B. T., Clinch, S., Wild, S. E., & McNaney, R. (2019). Understanding the Role of Healthy Eating and Fitness Mobile Apps in the Formation of Maladaptive Eating and Exercise Behaviors in Young People. JMIR mhealth and uhealth. https://doi.org/10.2196/14239
- Robinson, P., Turk, D., Jilka, S., & Cella, M. (2018). Measuring attitudes towards mental health using social media: investigating stigma and trivialisation. Social Psychiatry and Psychiatric Epidemiology. https://doi.org/10.1007/s00127-018-1571-5
- Safa, R., Bayat, P., & Moghtader, L. (2021). Automatic detection of depression symptoms in twitter using multimodal analysis. The Journal of Supercomputing. https://doi.org/10.1007/s11227-021-04040-8
- Tse, C.‐S., Yap, M. J., Chan, Y.‐L., Sze, W. P., Shaoul, C., & Lin, D. (2016). The Chinese Lexicon Project: A megastudy of lexical decision performance for 25,000+ traditional Chinese two-character compound words. Behavior Research Methods. https://doi.org/10.3758/s13428-016-0810-5
- Zhang, Y., Lyu, H., Liu, Y., Zhang, X., Wang, Y., & Luo, J. (2021). Monitoring Depression Trends on Twitter During the COVID-19 Pandemic: Observational Study. JMIR Infodemiology. https://doi.org/10.2196/26769