
تمثل عملية إدارة البيانات واستيرادها الركيزة الأساسية التي تقوم عليها موثوقية الأبحاث الكمية والدراسات الإحصائية المتقدمة. وفي المشهد الأكاديمي والتحليلي المعاصر، تبرز بيئة نظام التحليل الإحصائي (SAS) كواحدة من أكثر المنصات رسوخاً واعتماداً لمعالجة البيانات المعقدة وإجراء النمذجة الإحصائية عالية الدقة. ترجع جذور هذا النظام إلى عام 1966 في جامعة ولاية كارولاينا الشمالية ضمن مشروع كونسورتيوم ممول من وزارة الزراعة الأمريكية والمعاهد الوطنية للصحة، قبل أن يتم تأسيس معهد ساس رسمياً في عام 1976 على يد أنتوني بار وجيمس جودنايت وجون سال وجين هيلويغ، بالتزامن مع إصدار أول دليل مستخدم موحد للنظام. ومنذ ذلك الحين، تطورت أدوات النظام لتلائم التحولات المتسارعة في تنسيقات تخزين البيانات وطرائق تبادلها عبر مختلف المنصات البرمجية.
تواجه المشروعات البحثية والتطبيقية تحدياً متكرراً يتمثل في التعامل مع برمجيات الجداول الإلكترونية، وعلى رأسها مايكروسوفت إكسل (Microsoft Excel)، والتي تُعد الأداة الأكثر شيوعاً في جمع وتصنيف البيانات الأولية. ومع ذلك، فإن الطبيعة المرنة لجداول إكسل تؤدي في كثير من الأحيان إلى إنشاء مصنفات تحتوي على تقارير مدمجة، أو جداول متعددة ضمن ورقة العمل الواحدة، أو كتل بيانية محاطة بتعليقات وهوامش وصفية لا تشكل جزءاً من مصفوفة البيانات المستهدفة بالتحليل الإحصائي. ومن هنا تنبع ضرورة امتلاك الباحث لمهارة استخراج واستيراد نطاق محدد بدقة من ورقة العمل، متجاوزاً بذلك عوائق استيراد الورقة الكاملة التي قد تفسد هيكل البيانات أو تؤدي إلى استهلاك غير مبرر للذاكرة الحاسوبية.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دليل منهجي وتطبيقي مفصل لآليات استيراد نطاق محدد من ملفات إكسل داخل بيئة ساس. سنستعرض عبر هذا الدليل الأسس النظرية والميكانيكية لإجراء الاستيراد القياسي، وقواعد الصياغة البرمجية المعتمدة لمحرك معالجة الملفات الحديثة، بالإضافة إلى تقنيات إدارة أسماء المتغيرات، وفحص البنية الميتادية، وتصحيح الأخطاء الشائعة، وصولاً إلى استراتيجيات الأتمتة المتقدمة وحوكمة سلامة البيانات في الدراسات متعددة التخصصات، بما يضمن أعلى درجات الموثوقية وقابلية التكرار في مسارات العمل التحليلية.
1. مقدمة عامة حول استيراد البيانات في بيئة ساس (SAS)
1.1 أهمية استيراد البيانات الجزئية في الأبحاث والتحليلات
في سياق إدارة البيانات الضخمة والمعقدة، يمثل التحميل العشوائي للبيانات الكاملة عبئاً تقنياً وإحصائياً على حد سواء. عندما يقوم الباحث بجلب ورقة عمل كاملة تحتوي على آلاف الأسطر والأعمدة المليئة بالهوامش أو البيانات الوصفية غير المكتملة، فإن ذلك يؤدي إلى حجز مساحات تخزينية غير مبررة داخل ذاكرة العمل المؤقتة للبرنامج. إن حجز موارد الذاكرة لا يقتصر أثره على إبطاء سرعة المعالجة الحاسوبية فحسب، بل يمتد ليؤثر سلباً على كفاءة الخوارزميات التحليلية المعقدة، لاسيما عند تطبيق نماذج الانحدار المتقدمة، أو إجراءات التحليل متعدد المستويات، أو خوارزميات التعلم الآلي التي تتطلب تدويراً مكثفاً للبيانات عبر الذاكرة العشوائية.
علاوة على ذلك، فإن عزل المتغيرات المعنية بالتحليل الإحصائي المباشر يسهم إسهاماً جوهرياً في تقليل ما يُعرف بالتشويش المنهجي في مجموعات البيانات. تحتوي العديد من ملفات جمع البيانات الأولية على أعمدة تكميلية، مثل أرقام التعريف الداخلية، أو التواريخ الإدارية، أو الملاحظات النصية الحرة للمشرفين الميدانيين، والتي لا تحمل قيمة إحصائية للاختبار الفرضي الراهن. إن استيراد هذه الحقول يزيد من احتمالية حدوث أخطاء الارتباط الزائف، ويعقد من مهمة فحص مصفوفات التباين والتباين المشترك، ويجعل عمليات التعديل والتنظيف أكثر عرضة للزلل البشري.
تتجلى هذه الأهمية بشكل أوضح عند التعامل مع ملفات البيانات المعقدة التي تحتوي على عدة جداول فرعية موزعة في مناطق مختلفة داخل ورقة العمل الواحدة. ففي الدراسات الميدانية واسعة النطاق، مثل المسوح النفسية والسلوكية التي تتناول استجابات فئات سكانية متنوعة عبر الزمن، غالباً ما يقوم الباحثون بوضع جداول ملخصة أو إحصاءات وصفية تمهيدية إلى جوار مصفوفة الاستجابات الخام. في مثل هذه البيئات المعقدة لجمع البيانات، كما هو موثق في دراسات التتبع واسعة النطاق لأحداث الحياة والبيانات البيولوجية والسلوكية (Zehr et al., 2014)، فإن القدرة على توجيه محرك ساس لاقتطاع مستطيل محدد بدقة من الخلايا تمثل الفارق الحاسم بين سير عمل تحليلي يتسم بالانسيابية والدقة، وسير عمل آخر يعاني من تشوهات مستمرة في مطابقة السجلات وتسمية الأعمدة.
تسهم المعالجة الجزئية المركزة كذلك في تحسين زمن المعالجة وتسريع دورة حياة التحليل الإحصائي. فعندما يقتصر محرك الاستيراد على قراءة نطاق ضيق محدد مسبقاً، تنخفض عمليات القراءة والكتابة على القرص الصلب، وتقل عمليات التحقق من نوع البيانات لكل خلية، مما يوفر بيئة استجابة فورية للمحلل الإحصائي، خصوصاً عند تكرار عمليات القراءة في خطوط الأنابيب التحليلية المؤتمتة أو عند استخدام حزم التحليل الدوري للبيانات الواردة من مراكز جمع متعددة.
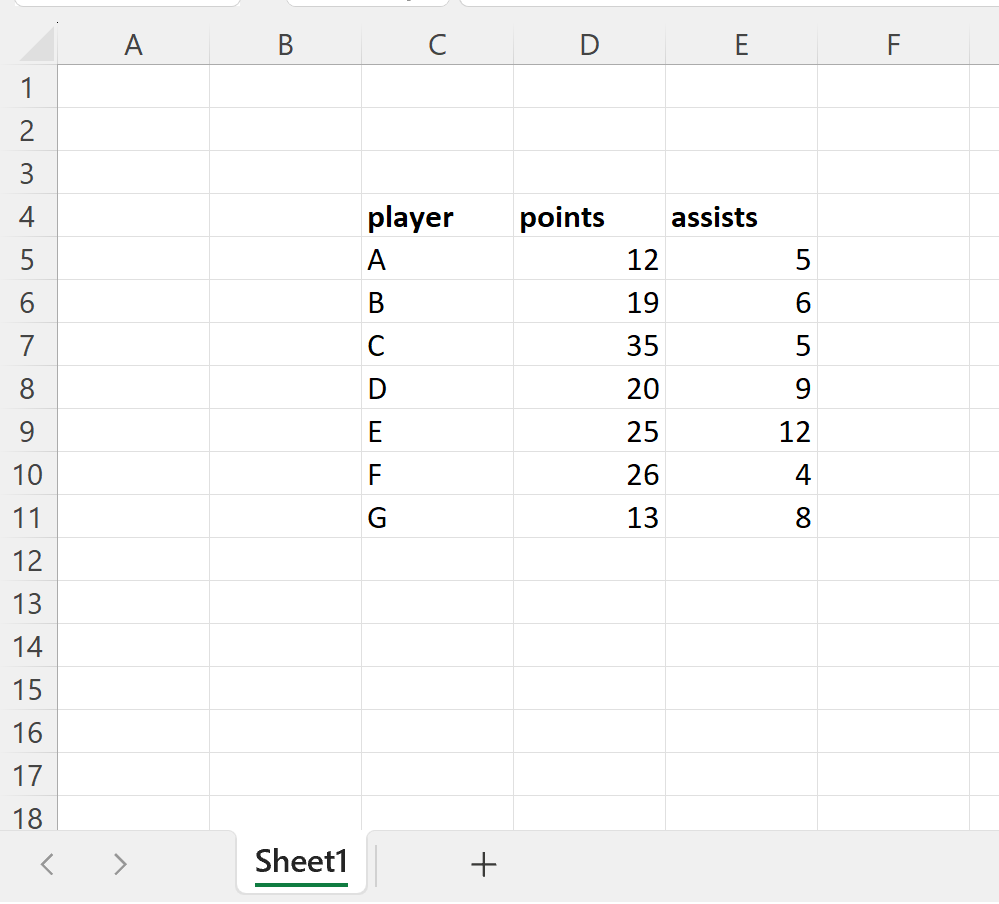
1.2 تكامل بيئة ساس مع جداول بيانات إكسل (Excel)
يعد التكامل بين نظام ساس وجداول إكسل واحداً من أكثر الجسور البرمجية استخداماً في الأوساط الأكاديمية والمؤسسية. يوفر محرك مكتبة التنسيق الحديث (DBMS=XLSX) في ساس مرونة استثنائية في قراءة ملفات المصنفات ذات الامتداد الحديث دون الحاجة إلى تثبيت برمجيات وسيطة مثل خوادم الوصول إلى ملفات الحاسوب الشخصي (PC-Files Server) أو الاعتماد على واجهات الربط المفتوح لقواعد البيانات (ODBC) المقيدة بهندسة المعمارية (32-bit مقابل 64-bit). هذا التحول التقني أتاح لبيئة ساس التفاعل المباشر مع الهيكل الداخلي لملفات إكسل المبنية على صيغة لغة الترميز القابلة للامتداد (OpenXML)، مما يضمن استقراراً برمجياً عالياً وموثوقية في تبادل البيانات عبر مختلف منصات التشغيل سواء كانت تعمل على بيئات ويندوز أو لينكس.
يتيح هذا التوافق المستمر بين منصات جمع البيانات وتطبيقات التحليل الإحصائي المتقدم بيئة عمل مرنة للباحثين؛ حيث يسهل جمع الاستجابات الأولية وإجراء الفحوصات الاستكشافية السريعة في إكسل، ثم نقل المصفوفة المحددة بسلاسة إلى ساس لإجراء المعالجة المعمقة والتحليلات البارامترية واللابارامترية المعقدة. ومع ذلك، فإن هذا التكامل لا يخلو من تحديات تقنية دقيقة، تأتي في مقدمتها إشكالية مطابقة أنواع البيانات (Data Type Mapping). يتميز إكسل بنظام مرن وخالٍ من القيود الصارمة في تعريف نوع محتوى الخلية الواحدة؛ إذ يمكن لعمود واحد أن يجمع بين أرقام صحيحة، وتواريخ، ونصوص توضيحية، وقيم مفقودة مكتوبة بصيغ مختلفة مثل الرموز الخاصة أو العبارات النصية.
في المقابل، يفرض نظام ساس بنية صارمة وثنائية للبيانات؛ فالمتغير إما أن يكون رقمياً (Numeric) أو حرفياً (Character). عند حدوث تباين داخل خلايا العمود المستورد من إكسل، يضطر محرك الاستيراد إلى اتخاذ قرار تصنيفي تلقائي قد ينجم عنه تحويل الأرقام إلى نصوص أو فقدان التنسيقات الحسابية الأصلية إذا لم تتم إدارة عملية الاستيراد بضوابط دقيقة. وهنا يبرز دور إجراء الاستيراد القياسي (PROC IMPORT) كأداة لا غنى عنها توفر توازناً مثالياً بين السرعة والمرونة التشغيلية، موفرة للمحلل ترسانة من المعاملات والخيارات التي تمكنه من فرض قيود التنسيق وتحديد أبعاد المصفوفة المستهدفة بكل دقة وعناية.
يوفر فهم الآلية الداخلية لعمل محرك الربط بين المنصتين أساساً متيناً لتفادي الإحباطات التقنية الشائعة، مثل اقتطاع النصوص الطويلة أو الخطأ في قراءة الفواصل العشرية. إن إدراك أن ساس يتعامل مع ملف إكسل كمصدر بيانات جدولي منظم، وليس مجرد ملف نصي مسطح، يدفع الباحث إلى توخي الحذر الشديد في صياغة أوامر الاستيراد بما يتوافق مع المعايير القياسية لسلامة البيانات في الأبحاث الكمية المعاصرة.
2. البنية الأساسية لإجراء الاستيراد PROC IMPORT
2.1 مكونات أمر الاستيراد ودور كل معامل
يُعد إجراء الاستيراد PROC IMPORT في ساس أداة برمجية متكاملة مصممة لتحويل ملفات البيانات الخارجية بمختلف أنواعها إلى مجموعات بيانات ساس قياسية (SAS Data Sets). تعتمد بنية هذا الإجراء على مجموعة من العبارات والمعاملات المترابطة التي توجه المترجم البرمجي بدقة نحو قراءة الملف المصدر ومعالجته. تتلخص البنية النحوية العامة للإجراء في استدعاء الأمر متبوعاً بالمعاملات الرئيسية، وتنتهي بعبارة التشغيل RUN، كما يتضح في البناء المنهجي التالي:
المعامل الأول: DATAFILE
يختص هذا المعامل بتحديد المسار الفعلي وموقع ملف المصدر على وسيط التخزين التابع للجهاز أو الخادم. يجب أن يُكتب المسار كاملاً ومتضمناً اسم الملف وامتداده الدقيق بين علامات تنصيص فردية أو زوجية. في الأنظمة التي تعمل على بيئات توزيع شبكية أو خوادم سحابية، يجب مراعاة استخدام فواصل المسارات الصحيحة (مثل استخدام الفواصل المائلة إلى الأمام في أنظمة يونكس ولينكس) لضمان قدرة النظام على الوصول المادي إلى الملف دون إثارة أخطاء فقدان المسار.
المعامل الثاني: OUT
يحدد هذا المعامل اسم مجموعة بيانات ساس المستهدفة التي ستتلقى البيانات المقروءة. يمكن توجيه البيانات إما إلى مكتبة العمل المؤقتة عبر الصياغة work.mydata أو الاكتفاء بكتابة الاسم المجرد mydata حيث تفترض البيئة تلقائياً إرسالها إلى مكتبة العمل التي تُحذف محتوياتها بمجرد إنهاء الجلسة البرمجية. أما إذا كان الهدف هو حفظ البيانات بشكل دائم، فيتم تحديد اسم مكتبة دائمة معرفة مسبقاً عبر عبارة LIBNAME، متبوعة بنقطة ثم اسم الجدول المراد إنشاؤه.
المعامل الثالث: DBMS
يقوم هذا المعامل بتعريف نوع ومحرك المعالجة الخاص بصيغة الملف المدخل. بالنسبة لملفات إكسل الحديثة ذات الامتداد XLSX، فإن القيمة القياسية الواجب إسنادها هي DBMS=XLSX. يوجه هذا الخيار نظام ساس إلى استخدام خوارزميات فك تشفير وتفكيك ملفات أوفيس المفتوحة المعتمدة على حزم XML المضغوطة، وهو ما يميزه عن الخيارات القديمة مثل EXCEL أو XLS التي كانت تعتمد على برمجيات محركات ميكروسوفت القديمة المعرضة لمشاكل التوافق والتحديث.
المعامل الرابع: REPLACE
يُعتبر هذا الخيار من الخيارات الإدارية الهامة في سطر تعريف الإجراء؛ إذ يمنح ساس الإذن الصريح باستبدال وإعادة كتابة مجموعة البيانات المستهدفة في حال كانت موجودة مسبقاً في المكتبة المحددة. في غياب هذا الخيار، سيقوم الإجراء بإيقاف التنفيذ وإصدار رسالة تحذير في سجل النظام (SAS Log) تفيد بأن مجموعة البيانات موجودة بالفعل ولم يتم تعديلها، وذلك لحماية البيانات الأصلية من الحذف غير المقصود أثناء تكرار التجارب البرمجية.
2.2 وظيفة محرك التنسيق DBMS=XLSX
أحدث إدخال محرك التنسيق DBMS=XLSX في إصدارات ساس الحديثة نقلة نوعية في موثوقية معالجة الجداول الإلكترونية. تاريخياً، كان استيراد ملفات إكسل محكوماً ببرمجيات الربط المعتمدة على نظام ويندوز، مما كان يخلق عوائق جمة للمؤسسات الأكاديمية والبحثية التي تشغل برمجيات ساس على حواسيب مركزية فائقة أو خوادم لينكس متعددة المستخدمين. أزال هذا المحرك المستقل كافة متطلبات الترخيص الإضافية للبرمجيات الوسيطة، وأتاح قراءة وكتابة ملفات XLSX بصورة أصلية ومباشرة عبر مختلف أنظمة التشغيل، وهو ما يعزز استقرار خطوط أنابيب تحليل البيانات.
يمتاز المحرك بقدرته الفائقة على قراءة خلايا إكسل وتفسير محتواها الداخلي مع الحفاظ على التمييز الدقيق بين التنسيقات المتنوعة. فهو قادر على فحص بنيات التواريخ، والأوقات، والنسب المئوية، والأرقام ذات الفواصل العشرية المتغيرة، وتعيين التنسيقات المقابلة لها تلقائياً في ساس (مثل التنسيقات DATE9. و DATETIME20. و COMMA12.2). علاوة على ذلك، يتعامل المحرك بذكاء مع تمثيل النصوص متعددة اللغات وترميز يونيكود (Unicode/UTF-8)، مما يقلل من مخاطر حدوث تشوهات في الحروف أو الرموز الخاصة باللغات غير اللاتينية كاللغة العربية.
من المزايا الجوهرية الأخرى لمحرك XLSX دعمه المتكامل لتعليمات حصر الاستيراد، وخاصة خياري استهداف أوراق عمل محددة والنطاقات المخصصة. يسمح المحرك للمترجم البرمجي بتجاوز القراءة الشاملة للمستند والانتقال المباشر إلى فهرس الخلايا المستهدفة، الأمر الذي يحد من استهلاك المعالج ويمنع التحميل الزائد للملفات التراكمية في البيئات البحثية التشاركية.
3. استكشاف خيار النطاق RANGE وتفاصيله الدقيقة
3.1 صياغة معيار RANGE وقواعد كتابته
يمثل خيار RANGE الأداة الجراحية الأكثر دقة في إجراء PROC IMPORT عند التعامل مع مصنفات إكسل ذات البنى غير المتجانسة. يسمح هذا المعامل للباحث بتحديد مصفوفة مستطيلة مغلقة من الخلايا، متجاوزاً بذلك كل ما يقع خارج حدود هذا المستطيل من نصوص، وجداول تكميلية، وأخطاء حسابية هامشية. لضمان التنفيذ البرمجي السليم دون توليد أخطاء تفسيرية، يجب الالتزام بقواعد النحو الصارم المعتمدة في ساس لصياغة هذا المعامل.
تتطلب القاعدة الأساسية كتابة المعامل متبوعاً بعلامة المساواة، ثم تضمين قيمة النطاق بالكامل بين علامتي تنصيص زوجيتين أو فرديتين، على النحو المنهجي: RANGE=”SheetName$CellStart:CellEnd”;. يتكون هذا التركيب من ثلاثة عناصر متسلسلة:
- اسم ورقة العمل متبوعاً بعلامة الدولار ($): يعمل هذا الرمز كفاصل منطقي يوجه محرك الاستيراد للبحث عن النطاق الإحداثي حصرياً داخل ورقة العمل المحددة، متفادياً البحث في الورقة النشطة افتراضياً.
- إحداثيات خلية البداية (CellStart): وتحدد الزاوية العلوية اليسرى من المصفوفة المستهدفة، مثل B5 أو C2.
- نقطتان رأسيتان (:): تمثلان عامل الربط الرياضي للدلالة على الاستمرارية الفضائية للخلايا الممتدة بين النقطتين.
- إحداثيات خلية النهاية (CellEnd): وتحدد الزاوية السفلية اليمنى المقابلة للمصفوفة، مثل G100 أو K50.
تعد مسألة حساسية الأحرف والمسافات في اسم ورقة العمل من النقاط الحرجة التي تسبب إخفاق الكود البرمجي في كثير من الأحيان. فإذا كان اسم الورقة في إكسل يحتوي على مسافات، كأن يكون باسم [Pilot Data]، فإن إغفال كتابة المسافة بدقة داخل علامات التنصيص في ساس سيؤدي إلى فشل المحرك في مطابقة الورقة وصدور رسالة خطأ صريحة. كما أن وضع أي مسافة زائدة قبل أو بعد علامة الدولار قد يُفسر من قبل المحرك كجزء من اسم الورقة أو كخطأ في بناء الجملة، مما يوجب الصرامة التامة في التحرير.
3.2 مقارنة خيار RANGE مع خيار SHEET
كثيراً ما يقع الخلط بين استخدام خيار الورقة الكاملة SHEET وخيار النطاق المخصص RANGE، على الرغم من التباين الجوهري في سلوك كل منهما داخل بيئة ساس. يوجه خيار SHEET=”SheetName”; المحرك لقراءة ورقة العمل بأكملها، بدءاً من الخلية الأولى المأهولة بالبيانات (والتي تفترض الخوارزمية عادةً أنها A1 ما لم تكن هناك فراغات علوية كاملة) وصولاً إلى أقصى خلية تحتوي على مدخلات أو تنسيقات متبقية في أقصى اليمين وأسفل الصفحة.
تكمن مشكلة خيار SHEET في أنه غير قادر على التمييز بين بيانات الدراسة الفعلية والملاحظات الجانبية التي قد يدونها الباحثون على هوامش الورقة. فإذا تضمنت الورقة جدولا رئيسياً في الخلايا A1 إلى D50، ثم وُضعت ملاحظة نصية توضيحية في الخلية M70، فإن خيار SHEET سيجبر ساس على استيراد مصفوفة هائلة تمتد من A1 إلى M70، مما يخلق مئات الخلايا الفارغة المحشوة بقيم مفقودة (Missing Values) ويولد متغيرات وهمية تثقل كاهل مجموعة البيانات وتؤدي إلى تشويه حجم العينة الفعلي.
في المقابل، يفرض خيار RANGE حدوداً صارمة لا يمكن للمحرك تخطيها. فهو يقتطع المصفوفة المحددة جراحياً، متجاهلاً أي محتوى يقع في محيطها الخارجي. ينعكس هذا الفارق بشكل حاسم على بنية المتغيرات المنشأة داخل ساس؛ فاستخدام RANGE يضمن احتساب العدد الصحيح للمتغيرات (الأعمدة) والمشاهدات (الصفوف) وفق التصميم التجريبي المحدد، مما يعفي الباحث من كتابة خطوات تنظيف إضافية باستخدام DATA STEP لحذف المتغيرات الفارغة والأسطر الزائدة الناتجة عن الاستيراد الشامل غير المنضبط.
من الأخطاء المنهجية الشائعة التي تجدر الإشارة إليها محاولة الجمع بين الخيارين معاً في أمر واحد، مثل كتابة: SHEET=”Survey”; RANGE=”Survey$A1:D50″;. يؤدي هذا الدمج غير الصحيح إلى خلق غموض تركيبي في مترجم ساس، مما ينتج عنه توقف تنفيذ الإجراء وتوليد أخطاء تعارض نحوي في سجل النظام. إن استخدام معيار RANGE المعرف بإحداثيات الورقة يُغني بالكامل عن استخدام SHEET، ويعد الأسلوب الأكثر أماناً ونقاءً من الناحية البرمجية.
4. التحضير المسبق لملف إكسل قبل تنفيذ عملية الاستيراد
4.1 معاينة بنية الخلايا وتحديد إحداثيات النطاق بدقة
تتطلب الإدارة المنهجية للبيانات فحصاً نقدياً مسبقاً لمصنف إكسل قبل الشروع في كتابة أوامر الاستيراد في ساس. لا يقتصر هذا الفحص على مجرد تسجيل إحداثيات الخلايا بالعين المجردة، بل يمتد إلى التحقق الهيكلي من اتساق المصفوفة الداخلية للخلايا المستهدفة. يجب أولاً تحديد ما إذا كان الصف الأول في النطاق يمثل عناوين أعمدة حقيقية ومعيارية، أم أنه يحتوي على قيم خام أو عناوين ثانوية مدمجة. إن الخلط في هذا التحديد ينعكس مباشرة على الخيار المنهجي التالي لمعامل GETNAMES.
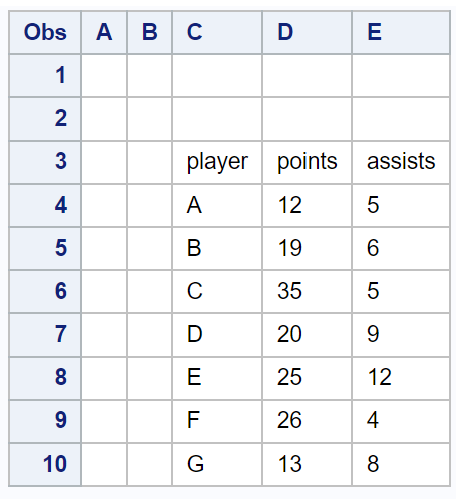
تعتبر الخلايا المدمجة (Merged Cells) من أخطر العوامل المسببة لتشوه البيانات عند الاستيراد. في برنامج إكسل، عند دمج خليتين أو أكثر (مثل دمج A1 و B1 لتمثيل عنوان عام مشترك)، فإن القيمة الحقيقية للبيانات تُخزن برمجياً في الخلية العلوية اليسرى فقط، بينما تصبح بقية الخلايا المدمجة فارغة تماماً من الناحية البرمجية الصرفة. عند استيراد نطاق يشتمل على خلايا مدمجة في صف العناوين أو في صفوف البيانات، يقوم ساس بتفسير الخلايا الفارغة كمتغيرات مجهولة الهوية أو كبيانات مفقودة، مما يحدث إزاحة كارثية في ترتيب الأعمدة وتوزيع المشاهدات.
لذلك، يتوجب على الباحث كخطوة تحضيرية فك دمج كافة الخلايا داخل النطاق المستهدف، والتأكد من أن كل عمود يمتلك رأساً فردياً واضحاً وغير مكرر، والتخلص من أي مجاميع فرعية (Subtotals) أو سطور فارغة فاصلة بين المجموعات التجريبية. تتكامل هذه الدقة مع ما تؤكده أدبيات التدخلات المنهجية والتحليلات البعدية الرصينة حول حساسية النتائج لنقاء المصفوفات المجمعة وتماسك تصنيفاتها (Heyvaert et al., 2011)، حيث إن أي خطأ في قراءة الحدود الإحداثية ينعكس على تقديرات المؤشرات الإحصائية اللاحقة.
كما يُنصح بمراجعة هوامش النطاق للتأكد من خلوها من المعادلات المعلقة أو التعليقات التي قد تمتد عن غير قصد إلى حواف الخلايا المستهدفة، وضمان أن مصفوفة البيانات تمثل شكلاً هندسياً مستطيلاً متكاملاً تتطابق فيه أبعاد المشاهدات عبر كافة المتغيرات المدرجة.
4.2 التأكد من إغلاق الملف وصلاحيات الوصول
من العوائق التشغيلية المتكررة التي يواجهها المحللون الإحصائيون محاولة استيراد بيانات من مصنف إكسل وهو لا يزال مفتوحاً وقيد التحرير في تطبيق مايكروسوفت إكسل على الجهاز نفسه. يقوم نظام تشغيل ويندوز في كثير من الأحيان بفرض قفل وصول حصري (Exclusive File Lock) على الملف المفتوح لمنع التعارضات الحسابية، مما يؤدي عند تشغيل كود ساس إلى توليد خطأ صريح في سجل النظام يشير إلى تعذر الوصول إلى الملف أو أنه قيد الاستخدام من قبل تطبيق آخر.
لتجنب هذا العطل البرمجي، يجب إغلاق ملف إكسل تماماً بعد الانتهاء من فحص إحداثياته وقبل إطلاق أمر الاستيراد في ساس. كذلك، في البيئات المؤسسية وشبكات الأبحاث التشاركية التي تعتمد على وحدات تخزين مشتركة أو خوادم سحابية، يجب التأكد من امتلاك حساب المستخدم لصلاحيات القراءة (Read Permissions) الكافية للمجلد الذي يحتوي الملف. قد يؤدي وجود الملف في مسار سحابي متزامن (مثل OneDrive أو SharePoint) دون اكتمال تنزيله محلياً إلى انقطاع جلسة القراءة وفشل الاستيراد.
يوصى دائماً بالاعتماد على المسارات المطلقة الكاملة (Absolute Paths) بدلاً من المسارات النسبية (Relative Paths)، وتجنب استخدام الرموز الخاصة أو المسافات الطويلة والمعقدة في أسماء المجلدات، لضمان استقرار قراءة وسائط التخزين من قبل نواة محرك ساس.
5. التطبيق العملي: بناء الجملة البرمجية لاستيراد نطاق محدد
5.1 النموذج القياسي لاستيراد نطاق خلايا محدد
لتوضيح التطبيق العملي الصارم، نفترض وجود دراسة نفسية تجريبية قامت بجمع استجابات عينة من المشاركين على مقاييس محددة، وحُفظت البيانات في ملف إكسل باسم psych_study_data.xlsx داخل مجلد أبحاث مخصص على القرص الصلب. تحتوي ورقة العمل الأولى، المسماة SurveyResponses، على جدول بيانات رئيسي يبدأ من الخلية B5 وينتهي في الخلية G100، في حين تشغل الخلايا السابقة والمحيطة بهذا النطاق ترويسات وملاحظات إدارية لا صلة لها بالتحليل الإحصائي.
لبناء النموذج القياسي لهذا الاستيراد، نستخدم إجراء PROC IMPORT مع تحديد خيار النطاق RANGE كما توضحه الصياغة المنهجية الآتية:
PROC IMPORT DATAFILE=”/path/to/psych_study_data.xlsx”
OUT=work.imported_data
DBMS=XLSX
REPLACE;
RANGE=”SurveyResponses$B5:G100″;
GETNAMES=YES;
RUN;
عند تنفيذ هذه الأسطر البرمجية، تتولى بيئة ساس ترجمة الأوامر خطوة بخطوة؛ حيث يحدد DATAFILE الموقع الفيزيائي الدقيق، ويحدد OUT إنشاء جدول جديد داخل مكتبة العمل باسم imported_data، ويوجه DBMS المحرك نحو معالجة بنية XLSX المفتوحة، بينما يتكفل خيار REPLACE بمسح أي نسخة سابقة تحمل الاسم نفسه لتجنب تضارب التكرار. تفرض عبارة RANGE حصر القراءة بين الخلية B5 والخلية G100 في ورقة SurveyResponses، ويعلن GETNAMES=YES أن الصف B5 يحتوي على مسميات المتغيرات.
عقب إطلاق الأمر، يتحتم على الباحث التوجه فوراً إلى سجل النظام (SAS Log) لقراءة رسائل التغذية الراجعة بعناية. يجب التحقق من ظهور رسالة النجاح القياسية التي توضح أن مجموعة البيانات قد تم إنشاؤها بنجاح مع ذكر العدد الدقيق للمشاهدات والمتغيرات المقروءة، والتأكد من مطابقة هذه الأرقام للمتوقع الحسابي (في حالتنا هذه: 95 مشاهدة و6 متغيرات، بافتراض أن الصف الأول كان مخصصاً للعناوين).
5.2 تطبيق عملي مقارن: الاستيراد بنطاق وبدون نطاق
لفهم القيمة المنهجية التي يضيفها خيار RANGE، يجدر بنا إجراء تحليل مقارن بين سيناريوهين للاستيراد من نفس ملف المصدر المعقد المذكور سابقاً. في السيناريو الأول، نقوم بتنفيذ استيراد عام للملف دون تحديد النطاق، باستخدام الكود المفتوح التالي:
PROC IMPORT DATAFILE=”/path/to/psych_study_data.xlsx”
OUT=work.full_sheet_data
DBMS=XLSX
REPLACE;
SHEET=”SurveyResponses”;
GETNAMES=YES;
RUN;
عند فحص مخرجات هذا الكود في نافذة عرض البيانات أو عبر الإجراءات الاستكشافية، نلاحظ الآتي: قامت بيئة ساس ببدء القراءة من الخلية A1. ونظراً لأن الخلايا من A1 إلى B4 كانت تحتوي على ملاحظات نصية عامة وتواريخ جمع متفرقة، فقد اعتبر ساس السطر A1 سطراً للعناوين، مما جعل أسماء المتغيرات تأخذ قيماً نصية غريبة ومشوهة. كذلك، تم تحويل أعمدة البيانات الرقمية في الجدول الأصلي إلى متغيرات نصية (Character Variables) لأن الأعمدة في أسطرها الأولى تضمنت نصوص الملاحظات الإدارية، فضلاً عن إنشاء مئات السجلات المحشوة بقيم مفقودة لتمثيل المساحات الفارغة المحيطة بالجدول.
في المقابل، عند النظر إلى مجموعة البيانات الناتجة عن السيناريو الثاني المقيد بالمعامل RANGE=”SurveyResponses$B5:G100″;، نجد أن الجدول الناتج نظيف تماماً؛ حيث اعتُمدت ترويسات الصف B5 كعناوين معيارية للمتغيرات، واحتُفظ بكافة القيم الرقمية داخل مصفوفة الاستجابات بنوعها الرقمي الأصلي، وتطابق عدد السجلات بدقة متناهية مع عدد المستجيبين الفعليين. يوفر هذا الاستهداف الجراحي عشرات الساعات التي كانت ستُهدر في معالجة التشويه الهيكلي وحذف الحقول الشاذة.
6. إدارة أسماء المتغيرات والتعامل مع خيار GETNAMES
6.1 استخدام GETNAMES=YES لاعتماد السطر الأول كعناوين
يلعب الخيار GETNAMES دوراً حاسماً في كيفية تفسير محرك الاستيراد للطبقة السطحية من النطاق المستهدف. عند ضبط GETNAMES=YES; (وهي القيمة الافتراضية في معظم بيئات ساس الحديثة)، يُصدر الإجراء تعليمات صارمة للمترجم باعتبار الصف الأول داخل النطاق الإحداثي المحدد هو صف العناوين الخاص بمسميات المتغيرات، وليس جزءاً من البيانات الرقمية أو النصية الخاضعة للتحليل.
تخضع أسماء المتغيرات في لغة ساس إلى قواعد اشتقاق صارمة (SAS Variable Naming Rules) تضمن توافقها مع محركات المعالجة الداخلية؛ إذ يجب ألا يتجاوز طول الاسم 32 حرفاً، ويجب أن يبدأ بحرف لاتيني أو بشرطة سفلية (_)، ولا يجوز أن يحتوي على فراغات أو علامات ترقيم خاصة كعلامات الاستفهام، أو الأقواس، أو علامات العملات. عند استخدام GETNAMES=YES مع ترويسات إكسل التي غالباً ما تُكتب بصيغ حرة وتحتوي على مسافات، يتدخل نظام ساس تلقائياً عبر ميكانيكية التنظيف النحوي:
- استبدال كافة المسافات والرموز غير المسموح بها بشرطات سفلية (_) لضمان تماسك الكلمة برمجياً.
- إضافة بادئة حرفية إذا كان اسم العمود في إكسل يبدأ برقم خالص، منعاً لحدوث أخطاء التعرف في مترجم ساس.
- اقتطاع الأسماء التي تتجاوز الحد الأقصى للأطوال مع الاحتفاظ بالأحرف الأولى لضمان التمييز الفريد.
تتجلى الأهمية الأكاديمية لهذا الإجراء في الحفاظ على الوضوح المفاهيمي للمتغيرات السلوكية والطبية المستوردة. فإذا كان النطاق المستهدف يبدأ بالصف المحتوي على أسماء المقاييس الدقيقة، فإن ساس سيقوم بتحويلها فوراً إلى أسماء متغيرات منتظمة يسهل استدعاؤها في خطوات النمذجة اللاحقة دون الحاجة إلى إعادة تسميتها يدوياً.
6.2 استخدام GETNAMES=NO في غياب العناوين الرسمية
في العديد من سيناريوهات البحث الميداني، ترد ملفات البيانات الأولية من أجهزة القياس أو منصات التسجيل الإلكتروني في هيئة مصفوفات خام مجردة تفتقر تماماً إلى صف العناوين، حيث يمثل الصف الأول من النطاق المشاهدة التجريبية الأولى للمشارك الأول. إذا تم استيراد هذا النطاق مع تفعيل الخيار الافتراضي GETNAMES=YES، فإن ساس سيقع في خطأ منهجي فادح؛ إذ سيعتبر بيانات المشارك الأول عناوين للأعمدة، مما يؤدي إلى حذف مشاهدة فعلية من حجم العينة وتحويل مسميات المتغيرات إلى أرقام مستخرجة من تلك الاستجابة الأولى.
لتفادي هذا الخلل، يتعين على الباحث الضبط الصريح للخيار عبر كتابة GETNAMES=NO;. في هذه الحالة، يتصرف محرك الاستيراد وفق بروتوكول بديل ومنظم:
- تضمين كافة صفوف النطاق المستهدف، بدءاً من الصف الأول وحتى الصف الأخير، كبيانات خام متكافئة ضمن مصفوفة المشاهدات.
- توليد أسماء افتراضية ومنتظمة للمتغيرات المستحدثة بصيغة قياسية تبدأ بكلمة VAR متبوعة برقم تسلسلي تصاعدي يمثل ترتيب العمود داخل النطاق المستورد (مثل VAR1, VAR2, VAR3, …).
- الحفاظ الكامل على الخصائص الرقمية للصف الأول ومنع فقدان أي وحدة تجريبية من العينة الإحصائية المستهدفة.
عقب إتمام هذا الاستيراد المجرد، يصبح بإمكان الباحث توظيف خطوة معالجة البيانات القياسية (DATA STEP) مع استخدام عبارة التسمية RENAME لإعادة تعيين أسماء دالة ومعبرة للمتغيرات بصورة منهجية وموثقة، كما يتضح من البناء التالي:
DATA work.refined_study_data;
SET work.imported_data;
RENAME VAR1 = Participant_ID
VAR2 = Reaction_Time
VAR3 = Anxiety_Score;
RUN;
تضمن هذه الاستراتيجية ذات المرحلتين الحفاظ التام على سلامة البيانات الرقمية الأصلية، وتتيح للمحلل الإحصائي توثيق التحويلات التسموية بدقة داخل الكود التكراري بما يخدم أهداف الشفافية المنهجية وإمكانية إعادة الإنتاج في الأبحاث العلمية.
7. فحص وتدقيق البيانات المستوردة بعد تنفيذ الكود
7.1 استخدام إجراء PROC CONTENTS للتحقق من السمات الميتادية
لا تنتهي مسؤولية الباحث الإحصائي بمجرد نجاح تشغيل إجراء الاستيراد وغياب رسائل الخطأ في سجل النظام؛ إذ إن الفحص الميتادي الصارم يُعد خطوة إجبارية للتأكد من أن البيانات قد استقرت في بيئة ساس بالخصائص الهيكلية المطلوبة. تمثل الميتاداتا (Metadata) بطاقة الهوية الخاصة بمجموعة البيانات، والتي تحدد مواصفات كل متغير من حيث نوعه، وطوله التخزيني، وتنسيقه المالي أو الحسابي، ومسماه الوصفي.
يعد إجراء المحتويات PROC CONTENTS الأداة القياسية لفحص هذه الخصائص. يُستدعى الإجراء بكود موجز وفعال:
PROC CONTENTS DATA=work.imported_data DETAILS;
RUN;
عند تفحص المخرجات المولدة من هذا الإجراء في شاشة النتائج، يجب على الباحث إيلاء اهتمام فائق لثلاثة مؤشرات جوهرية:
- نوع المتغير (Type): التأكد من أن المتغيرات المقاسة كمياً (مثل العمر، ودرجات الاختبارات، والمقاييس النفسية) قد سُجلت كمتغيرات رقمية (Numeric). إذا ظهر متغير كمي كمتغير نصي (Char)، فإن ذلك يشير إلى وجود مدخلات نصية شاذة داخل خلايا ذلك العمود في إكسل (مثل إدخال كلمة “مفقود” أو رمز خاص)، مما أجبر المحرك على تحويل العمود بأكمله إلى نص.
- طول المتغير (Length): فحص أطوال المتغيرات النصية المستوردة. يقوم ساس أحياناً بضبط طول المتغير النصي بناءً على أطول نص تمت قراءته في الأسطر الأولى؛ لذا يجب التحقق من عدم اقتطاع النصوص الطويلة ذات الدلالات الوصفية.
- التنسيقات العامة (Formats): مراجعة كيفية تمثيل التواريخ والأوقات لضمان عدم تحولها إلى قيم عددية مجردة تفقد سياقها الزمني عند إجراء التحليلات الطولية.
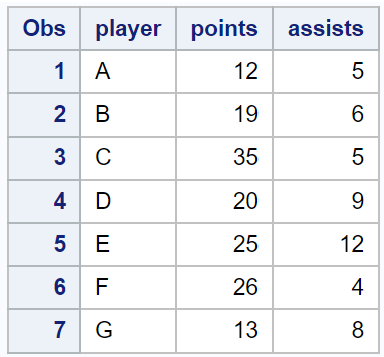
إن إجراء هذه الرقابة الميتادية يحصن المسار التحليلي من الانهيار في المراحل المتقدمة، ويتماشى مع المتطلبات المنهجية المعاصرة لتوثيق جودة البيانات وضمان سلامة المتغيرات الوسيطة والتابعة في النماذج الإحصائية المعقدة.
7.2 استعراض العينة الميدانية عبر إجراء PROC PRINT
بينما يوفر إجراء PROC CONTENTS نظرة ميتادية شاملة على خصائص الهيكل، يأتي إجراء الطباعة PROC PRINT ليتيح المعاينة البصرية المباشرة للمصفوفة الرقمية المستوردة. تسمح هذه المعاينة بمطابقة القيم الظاهرة على شاشة ساس بالقيم المقابلة لها في جدول إكسل الأصلي، مما يسهم في اكتشاف أي انزياح محتمل في الأعمدة أو تداخل في الصفوف في وقت مبكر.
لتجنب إغراق شاشة النتائج بمئات أو آلاف الأسطر، وخاصة عند التعامل مع مجموعات البيانات الكبيرة، يُنصح بشدة باستخدام خيار تقييد المشاهدات (OBS=n) لمعاينة عينة أولية محددة، كما يتضح في البناء التالي:
PROC PRINT DATA=work.imported_data (OBS=10);
RUN;
يمكن تدعيم هذه المعاينة باستخدام عبارة تحديد المتغيرات VAR لحصر الطباعة على المتغيرات المستحدثة أو المتغيرات الحساسة للتحقق من عدم اختلاط البيانات:
PROC PRINT DATA=work.imported_data (OBS=15);
VAR Participant_ID Anxiety_Score Reaction_Time;
RUN;
تتيح هذه المراجعة البصرية التأكد من دقة محاذاة البيانات؛ فعلى سبيل المثال، يمكن رصد ما إذا كانت ترويسات الأعمدة قد انزلقت لتصبح السجل الأول، أو ما إذا كانت القيم المفقودة قد مُثلت بنقاط عشرية قياسية في ساس (.) للمتغيرات الرقمية ومساحات بيضاء للمتغيرات النصية، بدلاً من بقائها كنصوص شاذة قد تؤدي إلى تشويه التحليلات الإحصائية الوصفية والاستدلالية.
8. معالجة الأخطاء الشائعة وحل المشكلات التقنية
8.1 أخطاء المسارات غير الصحيحة وأسماء الأوراق الخاطئة
يواجه مستخدمو ساس حزمة من الأخطاء التقنية المألوفة عند تنفيذ إجراءات الاستيراد، والتي يمكن تجاوزها بسهولة بمجرد فهم أسبابها الجذرية. يأتي في مقدمة هذه الأخطاء الرسالة الشهيرة: ERROR: Physical file does not exist. تشير هذه الرسالة بشكل قاطع إلى عجز نظام ساس عن العثور على ملف إكسل في المسار المحدد داخل المعامل DATAFILE. تنشأ هذه المشكلة في الغالب عن أخطاء إملائية في كتابة المسار، أو إغفال امتداد الملف (.xlsx)، أو استخدام فواصل مائلة غير متوافقة مع نظام التشغيل المستضيف، أو نقل الملف من موقعه دون تحديث الكود البرمجي المقابل.
الخطأ الشائع الآخر يرتبط بفشل قراءة النطاق نتيجة عدم تطابق اسم ورقة العمل، حيث يُصدر النظام رسالة تفيد بتعذر العثور على النطاق المحدد أو أن الورقة غير معرفة. يعود ذلك عادة إلى وجود مسافات بيضاء مخفية في نهاية اسم الورقة داخل برنامج إكسل (مثل كتابة “Data ” بدلاً من “Data”)؛ إذ يتعامل إكسل مع هذه المسافة كجزء أصيل من اسم الورقة، بينما يكتبها الباحث في كود ساس مجردة، مما يؤدي إلى فشل التطابق. لحل هذه المعضلة، يجب فحص اسم الورقة داخل إكسل وإعادة تسميتها بدقة وتجريدها من أي مسافات غير مرئية.
كذلك، تبرز مسألة حساسية الترميز عند استخدام لغات متعددة في تسمية أوراق العمل، لاسيما عند استخدام الحروف العربية. إذا كانت جلسة ساس مهيأة بترميز محلي ضيق لا يدعم اليونيكود متعدد اللغات، فقد يفشل المترجم في قراءة اسم الورقة العربي داخل عبارة RANGE. يكمن الحل هنا إما في توحيد تسمية أوراق العمل باللغة الإنجليزية في ملفات المصدر، أو التأكد من تشغيل ساس ببيئة تدعم ترميز UTF-8 الموسع.
8.2 مشاكل تباين أنواع البيانات واقتطاع النصوص
تعتبر مشكلة تباين أنواع البيانات (Mixed Data Types) داخل العمود الواحد من أكثر التحديات التقنية تعقيداً عند استيراد البيانات من إكسل إلى ساس. تتيح مرونة إكسل إدخال نصوص توضيحية داخل أعمدة رقمية خالصة (مثل إدخال كلمة “غير متوفر” أو “N/A” داخل عمود درجات الاختبار). عندما يشرع محرك XLSX في مسح العمود، فإنه يفحص عينة من الأسطر الأولى لتحديد النوع الغالب؛ فإذا وجد قيماً نصية، فقد يقوم بتحويل العمود كاملاً إلى متغير نصي، مما يحرم الباحث من إجراء العمليات الحسابية عليه في ساس، أو يقوم بالعكس بتحويل النصوص إلى قيم مفقودة بصورة غير موثقة.
تتفاقم هذه المشكلة في الحقول النصية الطويلة، مثل الإجابات المفتوحة في الاستبانات السلوكية؛ حيث يقوم محرك الاستيراد أحياناً بضبط طول المتغير الحرفي ليتطابق مع أول مدخل يقرؤه، مما يؤدي إلى اقتطاع (Truncation) البيانات النصية الأطول الواردة في الأسطر اللاحقة وفقدان معلومات نوعية هامة. للتعامل المنهجي مع هذه المعضلة، يلجأ المحللون إلى خيارين:
- إجراء تنظيف مسبق وصارم لملف إكسل عبر توحيد صياغة القيم المفقودة وإزالة النصوص العارضة من الأعمدة الحسابية.
- تجاوز إجراء PROC IMPORT عند الضرورة واستخدام محرك المكتبات LIBNAME XLSX المباشر مع خطوة DATA STEP؛ حيث يتيح هذا الأسلوب تحديد أطوال المتغيرات يدوياً عبر عبارة LENGTH وتطبيق دوال التحويل الصريح (مثل دالة INPUT لتحويل النصوص إلى أرقام، ودالة PUT للعكس) بمرونة وتحت رقابة برمجية كاملة.
تتصل بهذه المشاكل أيضاً إشكالية اختلاف النظم الحسابية لتخزين التواريخ؛ حيث يعتمد إكسل تاريخ 1 يناير 1900 كنقطة بداية للعد التسلسلي، بينما يعتمد نظام ساس تاريخ 1 يناير 1960 كنقطة الصفر الأساسية. يؤدي عدم إدراك محرك الاستيراد لهذا التمايز، في حال تلف التنسيقات المدمجة، إلى ظهور التواريخ كأرقام صحيحة شاذة تتطلب معالجة جبرية لإعادتها إلى أصلها التقويمي الصحيح.
9. تقنيات متقدمة: النطاقات المسماة واستيراد النطاقات الديناميكية
9.1 التعامل مع النطاقات المسماة (Named Ranges) في إكسل
تمثل النطاقات المسماة (Named Ranges) في برنامج إكسل ميزة هيكلية متقدمة ترفع من كفاءة ونظافة المعالجة البرمجية عند ربطها بنظام ساس. تتيح هذه الميزة للباحث تحديد مستطيل البيانات المستهدف داخل إكسل وتسميته باسم برمجي وحيد ومستقل (مثل إطلاق اسم ScaleItems على النطاق C2:K50) عبر مدير الأسماء (Name Manager) في إكسل، مما يجعل النطاق كياناً معرفاً بذاته على مستوى المصنف بأكمله.
تكمن القوة المنهجية لاستخدام النطاق المسمى في بساطة استدعائه داخل ساس؛ حيث يُستغنى تماماً عن ذكر اسم ورقة العمل أو علامات الدولار أو الإحداثيات المتغيرة للخلايا. تُصاغ عبارة الاستيراد عندئذ على النحو التالي:
PROC IMPORT DATAFILE=”/path/to/psych_study_data.xlsx”
OUT=work.imported_scale
DBMS=XLSX
REPLACE;
RANGE=”ScaleItems”;
GETNAMES=YES;
RUN;
يوفر هذا النهج ميزة حاسمة في استدامة المشاريع البحثية طويلة الأمد؛ فإذا تم تحديث ملف إكسل لاحقاً عبر إضافة صفوف جديدة من المشاركين أو أعمدة إضافية من المتغيرات، يكفي تعديل حدود النطاق المسمى داخل إكسل دون الحاجة إلى تعديل سطر واحد من الكود البرمجي في ساس. يقلل هذا التجريد من احتمالية وقوع أخطاء النسخ واللصق ويدعم استقرار الأنابيب التحليلية المعتمدة على ملفات دورية التحديث.
يمكن كذلك استدعاء النطاقات المسماة مباشرة عبر محرك المكتبات LIBNAME XLSX، حيث يظهر النطاق المسمى في مكتبة ساس كجدول بيانات مستقل ومباشر يمكن التعامل معه باستخدام تعليمات لغة ساس القياسية:
LIBNAME xl XLSX “/path/to/psych_study_data.xlsx”;
DATA work.direct_scale;
SET xl.ScaleItems;
RUN;
LIBNAME xl CLEAR;
9.2 أتمتة استيراد النطاقات باستخدام لغة الماكرو (SAS Macro)
في المشروعات البحثية المتقدمة التي تتضمن جمع بيانات طولية أو تقارير دورية متكررة من مراكز متعددة، تصبح كتابة أكواد استيراد منفصلة لكل نطاق أو ملف عملية تفتقر إلى الكفاءة وتزيد من احتمالية الخطأ. توفر لغة الماكرو في ساس (SAS Macro Facility) إمكانية تحويل كود الاستيراد الثابت إلى دالة ديناميكية عالية المرونة تقبل المعاملات المتغيرة وتقوم بتكرار عمليات الجلب والمعالجة بصورة مؤتمتة وشاملة.
يمكن على سبيل المثال تصميم ماكرو برمجي يستقبل اسم ورقة العمل ونطاق الخلايا كمعاملات وسيطة، ومن ثم يقوم بتنفيذ عملية الاستيراد وإنشاء أسماء جداول متسلسلة تلقائياً، كما يوضح النموذج التطبيقي التالي:
%MACRO ImportSubRange(file=, sheet=, startcell=, endcell=, outds=);
PROC IMPORT DATAFILE=”&file”
OUT=&outds
DBMS=XLSX
REPLACE;
RANGE=”&sheet$%NRSTR(&startcell):&endcell”;
GETNAMES=YES;
RUN;
%MEND ImportSubRange;
للقيام باستيراد نطاقات متعددة تمثل موجات زمنية مختلفة داخل نفس الملف أو ملفات مختلفة، يمكن للمحلل استدعاء هذا الماكرو عبر حلقة تكرارية بسيطة أو استدعاءات متتابعة وواضحة:
%ImportSubRange(file=/path/study.xlsx, sheet=Wave1, startcell=B2, endcell=M100, outds=work.wave_one);
%ImportSubRange(file=/path/study.xlsx, sheet=Wave2, startcell=B2, endcell=M100, outds=work.wave_two);
عقب إتمام عمليات الاستيراد المتعددة، تتيح أدوات ساس دمج الجداول المستوردة المتعاقبة في جدول بيانات نهائي موحد عبر خطوة الدمج التراكمي (Concatenation) باستخدام عبارة SET:
DATA work.combined_waves;
SET work.wave_one work.wave_two;
RUN;
تختزل هذه الأتمتة المنهجية مئات الأسطر من الأكواد اليدوية، وتحد من التدخل البشري المباشر، وتضمن تطبيق معايير ضبط جودة متطابقة وموحدة على كافة أجزاء المصفوفة التحليلية عبر مختلف مراحل البحث العلمي.
10. أفضل الممارسات المنهجية لإدارة بيانات التحليل الإحصائي
10.1 التوثيق البرمجي وقابلية تكرار النتائج الأكاديمية
تشدد المعايير الأكاديمية الحديثة في مجالات القياس الكمي والتحليل الإحصائي على مفهوم قابلية التكرار (Reproducibility)؛ وهو المبدأ الذي يقضي بقدرة باحث مستقل على الوصول إلى النتائج ذاتها عند تطبيق الإجراءات نفسها على البيانات الأصلية. في سياق استيراد البيانات من جداول إكسل، تتطلب قابلية التكرار توثيقاً برمجياً صارماً يوضح الأسباب المنهجية الكامنة وراء اختيار نطاق محدد دون غيره.
يجب أن تشتمل الملفات البرمجية على تعليقات وصفية توضيحية (Comments) توثق السياق الزمني واللوجستي لعملية الاستيراد. ينبغي على الباحث تدوين رقم إصدار ملف المصدر، وتاريخ تنزيله، والأساس المنطقي لاستبعاد الخلايا التي تقع خارج حدود النطاق المحدد (مثل توضيح أن الخلايا الخارجية تحتوي على مؤشرات مؤقتة لم تُعتمد في بروتوكول القياس النهائي). إن غياب مثل هذا التوثيق يجعل من العسير على لجان التحكيم العلمي أو الباحثين اللاحقين فهم مبررات تحديد الإحداثيات، مما يثير شكوكاً حول انتقائية البيانات (Data Cherry-picking).
يرتبط هذا النهج بالمعايير الصارمة لشفافية الإجراءات واستقرار مسارات التدريب والتقييم التي تناولتها دراسات المراجعة المنهجية للبيانات المتقدمة وحلول الذكاء الاصطناعي (Chan et al., 2021)، حيث تمثل خطوات هندسة المدخلات وتنقية النطاقات المستوردة حجر الزاوية في بناء نماذج إحصائية وتنبؤية تتسم بالمتانة والاتساق الداخلي.
تتكامل الممارسة الرصينة كذلك مع حفظ الأكواد ضمن مستودعات منظمة تدعم أدوات تتبع التغيير (Version Control Systems مثل Git)، مما يتيح مراجعة التطور التاريخي لكود الاستيراد والعودة إلى الصياغات السابقة عند الضرورة، وهو ما يعزز النزاهة العلمية للعمل البحثي برمته.
10.2 معايير الأمان والحفاظ على سلامة البيانات المصدرية
تمثل حماية البيانات المصدرية وصيانتها من التعديل العارض أحد أهم أركان الحوكمة المنهجية للبيانات. تتميز جداول بيانات إكسل بقابليتها العالية للتعديل غير المقصود؛ فمجرد نقرة زر خاطئة أو تعديل عشوائي في محاذاة الخلايا قد يؤدي إلى تغيير قيم القياسات الحيوية أو السلوكية دون أن يترك النظام أثراً تدقيقياً واضحاً للتغيير. لذلك، يجب تطبيق سياسة القراءة فقط (Read-Only) على مستوى نظام التشغيل لكافة ملفات إكسل الخام المستخدمة في الأبحاث، بحيث يُمنع أي مستخدم أو برنامج من إعادة الكتابة فوقها.
إلى جانب ذلك، يُعد إنشاء نسخ احتياطية مؤرخة (Time-stamped Backups) ومحفوظة في وسائط تخزين منفصلة ومشفرة خطوة أساسية تسبق مباشرة أي تفاعل تحليلي مع البيانات. يضمن هذا الإجراء إمكانية العودة إلى الحالة الصفرية للمصفوفة في حال حدوث أي تلف تقني في وسائط التخزين. كما يتعين على المحلل تجنب إجراء أي تحوير يدوي على ملف إكسل بغرض تيسير استيراده إلى ساس؛ بل يجب أن يتم استيراد النطاق بشكله الخام كما هو، وتُترك كافة مهام التنظيف، وإعادة التسمية، والترميز الحسابي لتُنفذ حصرياً داخل بيئة ساس عبر كود موثق وقابل للتدقيق بالكامل.
تكتسب هذه الحوكمة أهمية مضاعفة عند التعامل مع مجموعات البيانات متعددة الثقافات أو الحساسة، كما هو الحال في دراسات البنية الشخصية في المجتمعات المتنوعة ودراسات الصحة العامة المقارنة (Thalmayer et al., 2019)، حيث يضمن الفصل التام بين طبقة التخزين الخام وطبقة التحليل البرمجي بقاء البيانات الأصلية نقية وغير محرفة، مما يوفر أرضية صلبة لتفسير النتائج وتعميمها بموثوقية أكاديمية عالية.
وأخيراً، يتوجب إجراء فحص دوري لتوافق إصدارات بيئة ساس مع حزم الأوفيس المتجددة، لضمان استقرار محركات الاستيراد والتصدير، وتجنب حدوث أخطاء غير متوقعة في تفسير الفواصل العشرية أو علامات الترقيم عند ترقية البرمجيات أو الانتقال بين خوادم العمل المؤسسية.
خاتمة
استعرض هذا المقال الأكاديمي الموسع كافة الأبعاد المنهجية والتقنية المرتبطة بعملية استيراد نطاق محدد من جداول إكسل إلى بيئة نظام التحليل الإحصائي ساس (SAS). لقد تبين لنا من خلال التشريح التفصيلي لإجراء PROC IMPORT ومحرك التنسيق المتقدم DBMS=XLSX أن التحديد الدقيق للنطاقات المستهدفة باستخدام المعامل RANGE يمثل حلاً حاسماً لمشاكل تشوه البيانات واستهلاك الذاكرة الحاسوبية الناتجة عن الاستيراد الشامل للأوراق المعقدة. إن الإلمام بقواعد الصياغة البرمجية للنطاقات، وضبط خيار مسميات المتغيرات GETNAMES، وإجراء الفحوصات الميتادية والبصرية المنتظمة عبر إجراءي PROC CONTENTS و PROC PRINT، يشكل منظومة متكاملة تضمن دقة ونقاء البيانات قبل انطلاق مسارات التحليل الإحصائي المتقدم.
إن تبني هذه الممارسات البرمجية الرصينة وتدعيمها بتقنيات النطاقات المسماة والأتمتة الماكروية ليس مجرد مهارة تقنية تكميلية، بل هو التزام منهجي راسخ يدعم موثوقية الأبحاث الأكاديمية ويعزز قابلية تكرار نتائجها وشفافيتها. يتيح هذا النهج المرتكز على الحوكمة والتحكم الدقيق في البيانات للباحثين والمحللين بناء خطوط أنابيب استيراد متينة قادرة على استيعاب التغيرات الدورية في مصادر البيانات، مما يسهم في النهاية في رفع جودة الاستنتاجات العلمية والقرارات الاستراتيجية المستندة إلى الأدلة الإحصائية القاطعة.
المراجع
- Chan, V. C. H., Ross, G. B., Clouthier, A. L., Fischer, S. L., & Graham, R. B. (2021). The role of machine learning in the primary prevention of work-related musculoskeletal disorders: A scoping review. Applied Ergonomics. https://doi.org/10.1016/j.apergo.2021.103574
- Heyvaert, M., Maes, B., Van Den Noortgate, W., Kuppens, S., & Onghena, P. (2011). A multilevel meta-analysis of single-case and small-n research on interventions for reducing challenging behavior in persons with intellectual disabilities. Research in Developmental Disabilities. https://doi.org/10.1016/j.ridd.2011.10.010
- Thalmayer, A. G., Saucier, G., Ole‐Kotikash, L., & Payne, D. L. (2019). Personality structure in east and west Africa: Lexical studies of personality in Maa and Supyire-Senufo. Journal of Personality and Social Psychology. https://doi.org/10.1037/pspp0000264
- Zehr, S. M., Roach, R. G., Haring, D. M., Taylor, J., Cameron, F. H., & Yoder, A. D. (2014). Life history profiles for 27 strepsirrhine primate taxa generated using captive data from the Duke Lemur Center. Scientific Data. https://doi.org/10.1038/sdata.2014.19